1Introduction : comprendre l'idée d'un LLM
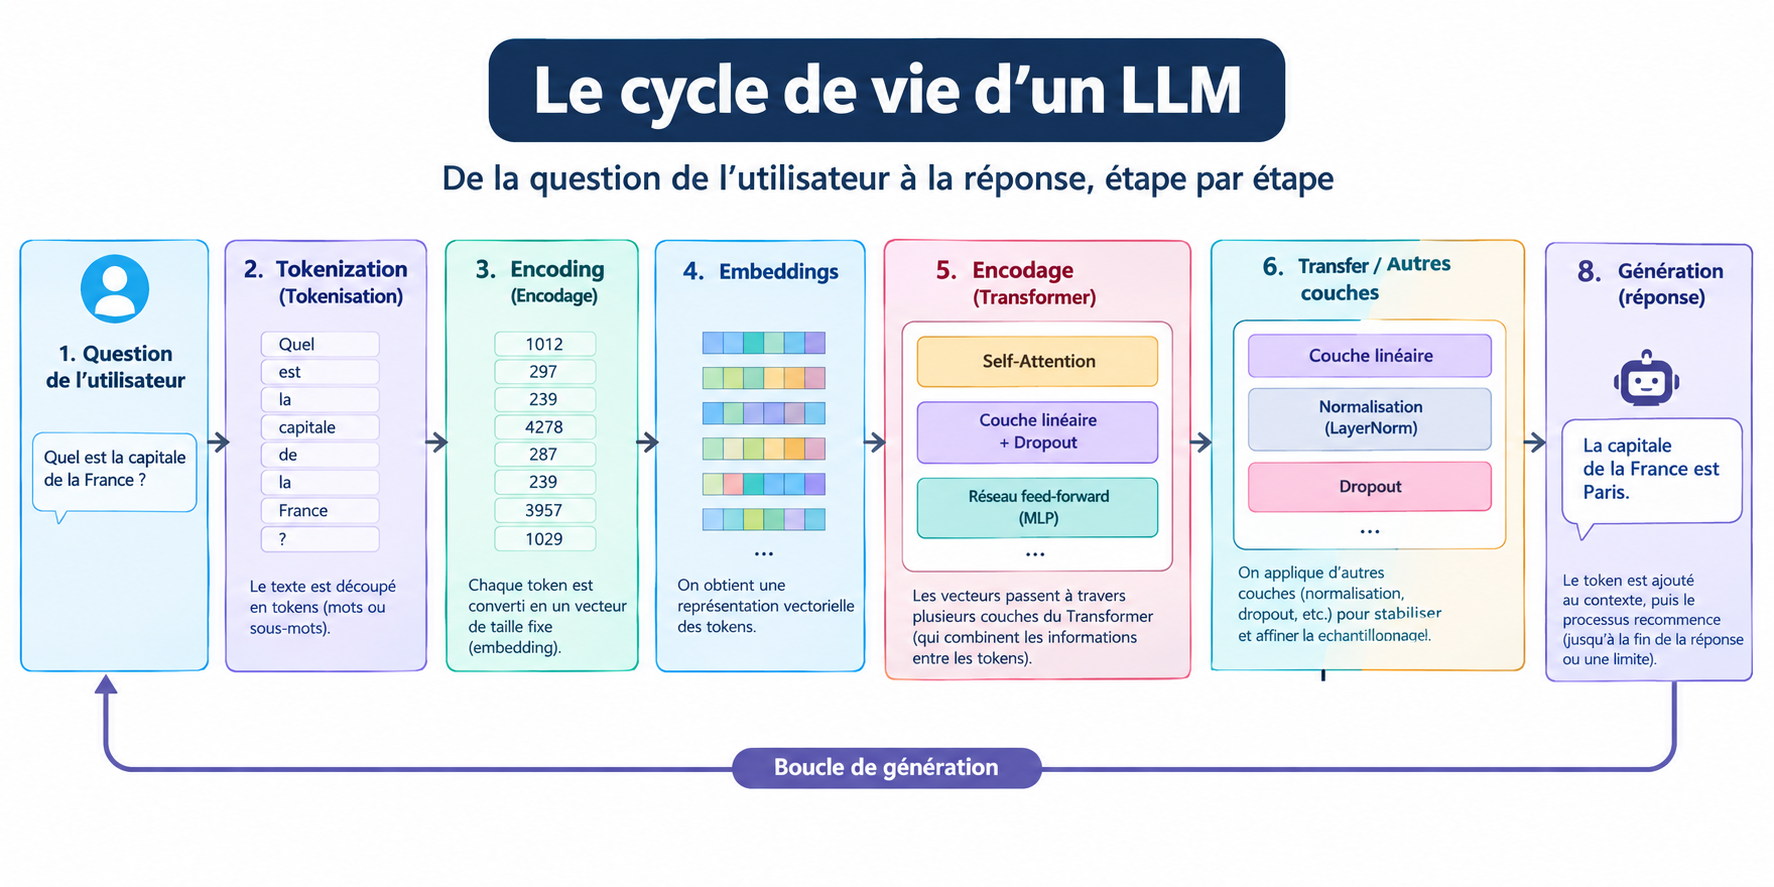
Un Large Language Model (LLM) est un modèle d'intelligence artificielle entraîné sur de grandes quantités de texte afin d'apprendre les régularités du langage. Son comportement visible - répondre à une question, résumer, traduire ou générer du code - repose sur une opération fondamentale : représenter le texte sous forme numérique, exploiter le contexte, puis estimer quel token est le plus plausible pour continuer la séquence.
La bande dessinée de la deuxième diapositive illustre une idée importante : pour l'utilisateur, l'échange semble naturel et linguistique ; pour la machine, l'information est manipulée sous forme de nombres. Le défi des LLM consiste précisément à construire des représentations numériques suffisamment riches pour préserver le sens et les relations entre les éléments du langage.
2Brève histoire des LLM
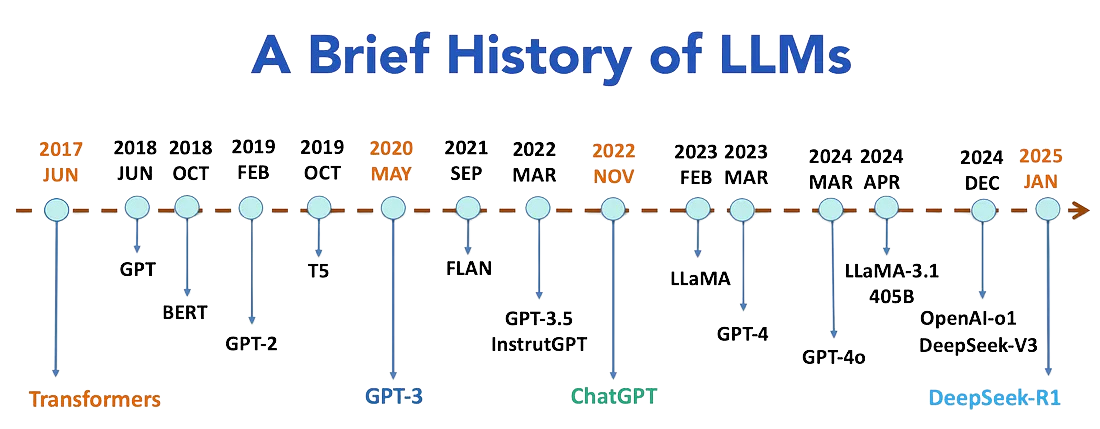
La présentation situe l'évolution moderne des LLM à partir de 2017, année marquée par l'architecture Transformer et l'article « Attention Is All You Need ». La chronologie montre ensuite l'accélération rapide des modèles : BERT, GPT-2, T5, GPT-3, FLAN, InstructGPT, ChatGPT, LLaMA, GPT-4, GPT-4o, LLaMA-3.1 405B, OpenAI o1 et la famille DeepSeek.
2017 — « Attention Is All You Need »
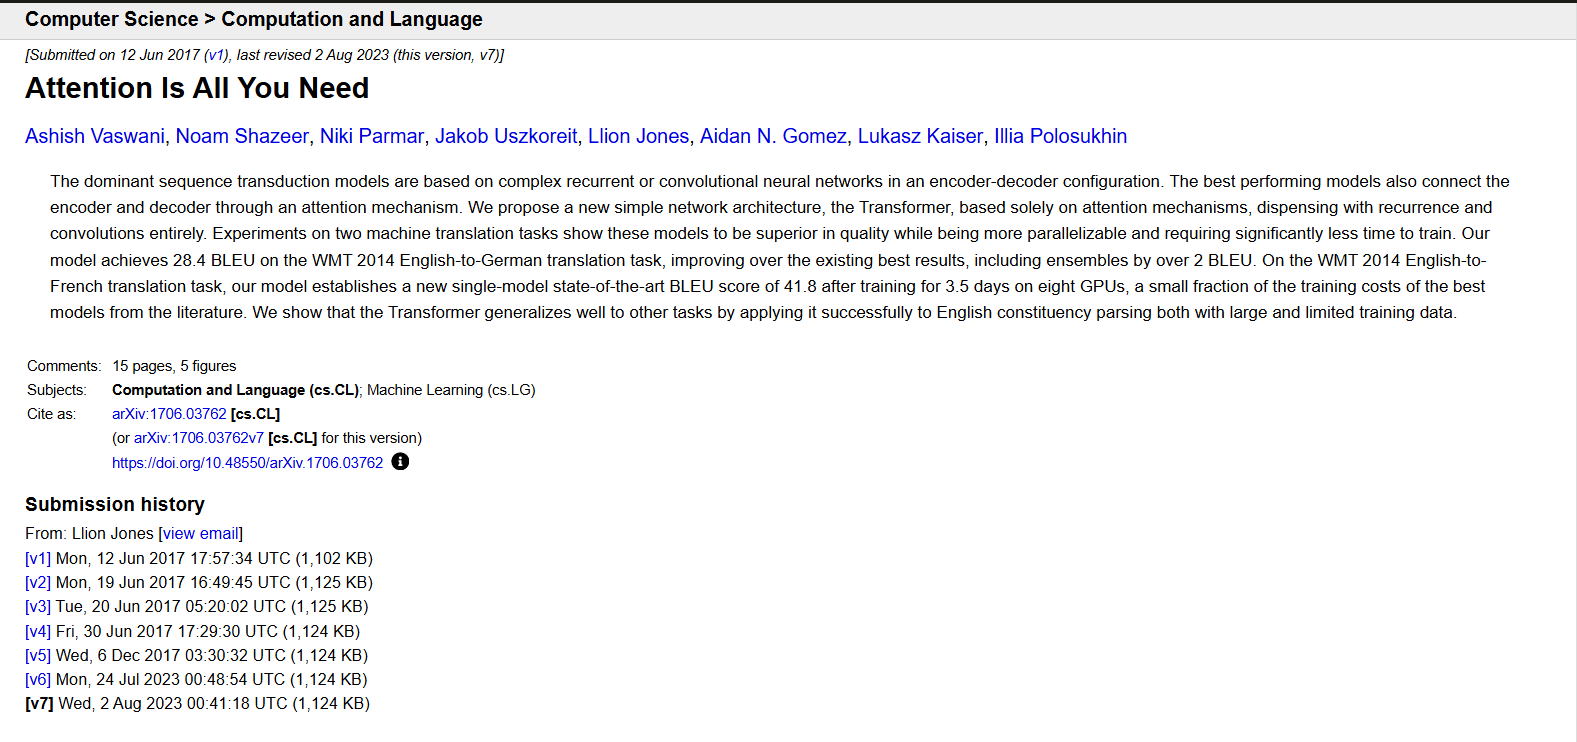
En 2017, des chercheurs de Google publient l'article « Attention Is All You Need », qui introduit l'architecture Transformer. Cette publication constitue l'un des tournants majeurs de l'histoire récente de l'intelligence artificielle et du traitement automatique du langage.
L'idée centrale du Transformer repose sur le mécanisme de Self-Attention. Au lieu de traiter les mots uniquement les uns après les autres, le modèle peut analyser les relations entre les différents tokens d'une séquence et déterminer lesquels sont les plus importants pour comprendre le contexte.
Le Transformer introduit notamment la Multi-Head Attention, qui permet au modèle d'observer plusieurs types de relations entre les tokens simultanément. Les Positional Encodings ajoutent également l'information sur la position des tokens, puisque l'attention seule ne représente pas naturellement leur ordre dans la séquence.
Pourquoi 2017 constitue un tournant
Avant les Transformers, les architectures séquentielles comme les RNN et les LSTM étaient largement utilisées en NLP. Leur nature séquentielle limitait cependant la parallélisation du traitement.
Le Transformer permet de traiter davantage d'éléments en parallèle et de mieux modéliser les dépendances à longue distance. Cette architecture a ainsi facilité l'entraînement de modèles beaucoup plus grands et est devenue la fondation de nombreuses familles de modèles modernes telles que BERT, GPT, T5 et LLaMA.
3Des RNN et LSTM aux Transformers
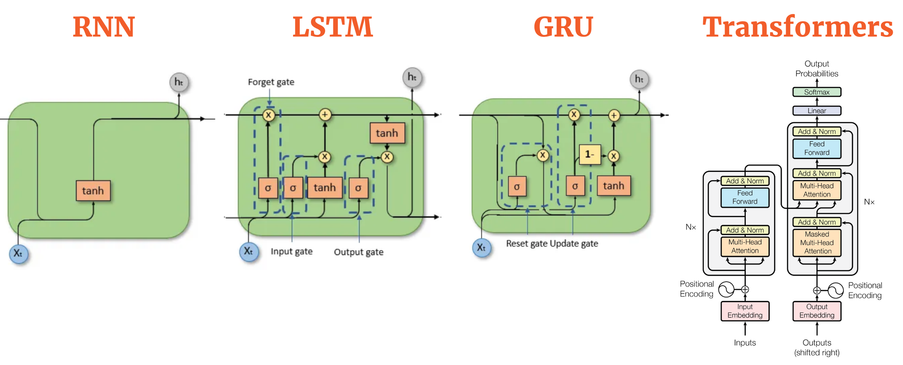
La présentation compare quatre familles d'architectures. Les RNN traitent naturellement les séquences mais rencontrent des difficultés lorsqu'il faut conserver une information sur de longues distances. Les LSTM et GRU introduisent des mécanismes de portes pour mieux contrôler la mémoire. Les Transformers changent l'approche : au lieu de dépendre principalement d'une propagation séquentielle de l'état caché, ils utilisent l'attention pour modéliser directement les relations entre positions.
4Position des LLM dans l'intelligence artificielle
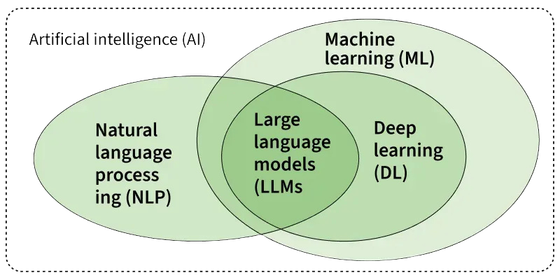
Le schéma de la présentation place les LLM à l'intersection du traitement automatique du langage (NLP), du Machine Learning et du Deep Learning. Cette représentation est utile pour comprendre que les LLM ne constituent pas toute l'intelligence artificielle : ils forment une famille de modèles profonds spécialisés dans la modélisation du langage, même si les modèles modernes peuvent également être multimodaux.
5Tokenisation et représentation numérique
5.1 Tokenisation
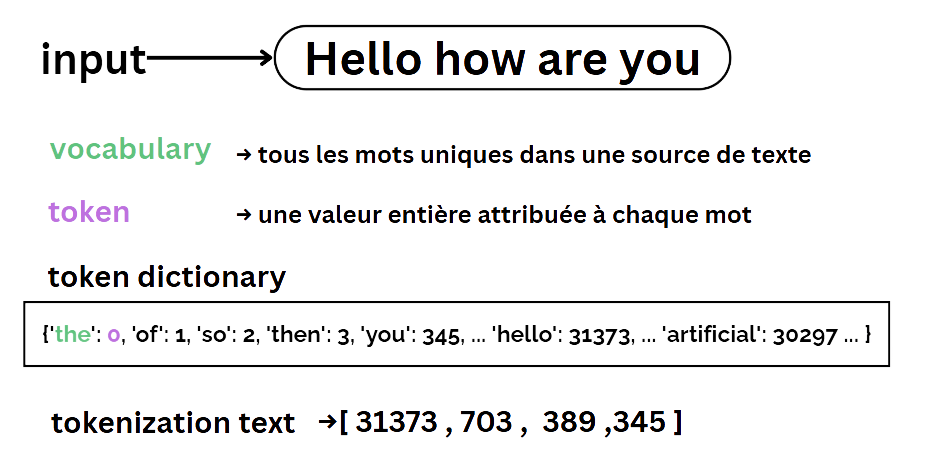
Le texte brut ne peut pas être envoyé directement à un réseau neuronal. Il est d'abord découpé en unités appelées tokens. La présentation utilise l'exemple « Hello how are you » et associe les unités à des identifiants entiers. Dans les systèmes modernes, un token peut correspondre à un mot, une partie de mot, un caractère ou un symbole selon le tokenizer.
5.2 One-hot encoding
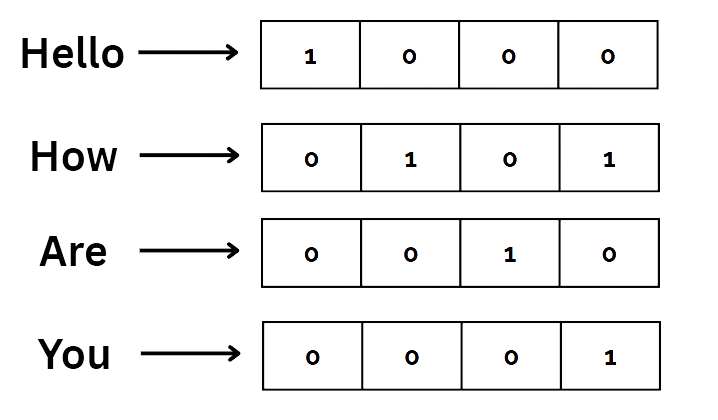
La présentation introduit ensuite le one-hot encoding : chaque élément du vocabulaire peut être représenté par un vecteur contenant un seul 1 et des 0 ailleurs. Cette méthode permet une représentation catégorielle simple, mais devient très coûteuse lorsque le vocabulaire est grand et n'exprime pas naturellement la similarité entre deux mots. C'est l'une des raisons pour lesquelles les embeddings denses sont essentiels dans les LLM.
6Embeddings : passer d'un identifiant à un espace vectoriel
Un embedding transforme chaque token en un vecteur dense de nombres réels. Contrairement au one-hot encoding, les dimensions ne correspondent pas simplement à une position unique dans le vocabulaire. Elles sont apprises pendant l'entraînement afin de fournir au réseau une représentation exploitable.
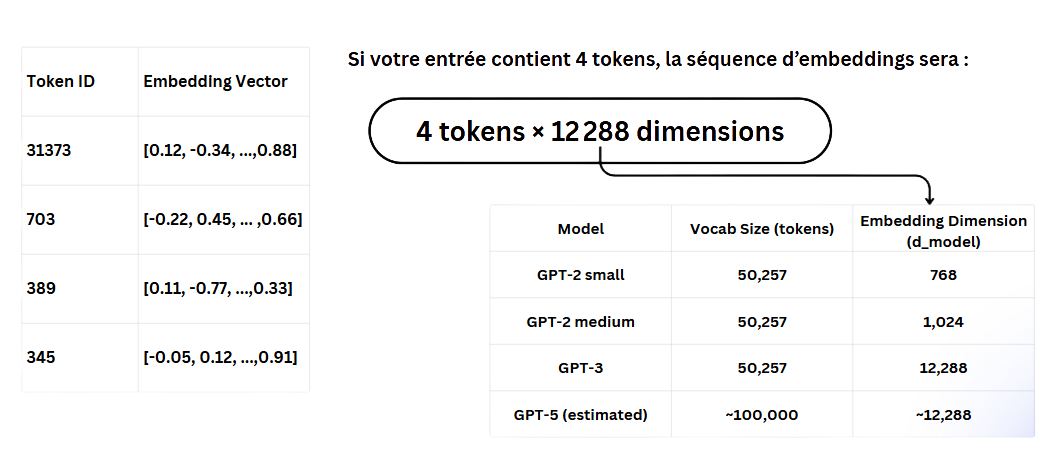
La diapositive donne des exemples de tailles de vocabulaire et de dimensions d'embedding, notamment pour GPT-2 et GPT-3. Elle illustre aussi qu'une séquence de quatre tokens devient une matrice : nombre de tokens × dimension d'embedding. La ligne relative à GPT-5 est explicitement indiquée comme « estimated » dans le support ; elle doit donc être comprise comme une estimation de la présentation et non comme une spécification officielle.
L'illustration de la page 11 généralise le concept : un objet de données est converti par un modèle d'embedding en un vecteur. Pour les LLM textuels, l'objet initial est généralement un token ou une séquence de tokens. Dans d'autres systèmes, le même principe peut s'appliquer à des images, de l'audio ou d'autres modalités.
7Encodage positionnel : ajouter l'ordre des tokens
L'attention, prise isolément, ne fournit pas automatiquement la notion d'ordre de la séquence. Le modèle doit donc disposer d'une information de position. La présentation décrit l'encodage positionnel sinusoïdal et montre l'addition entre token_embedding et positional_encoding.
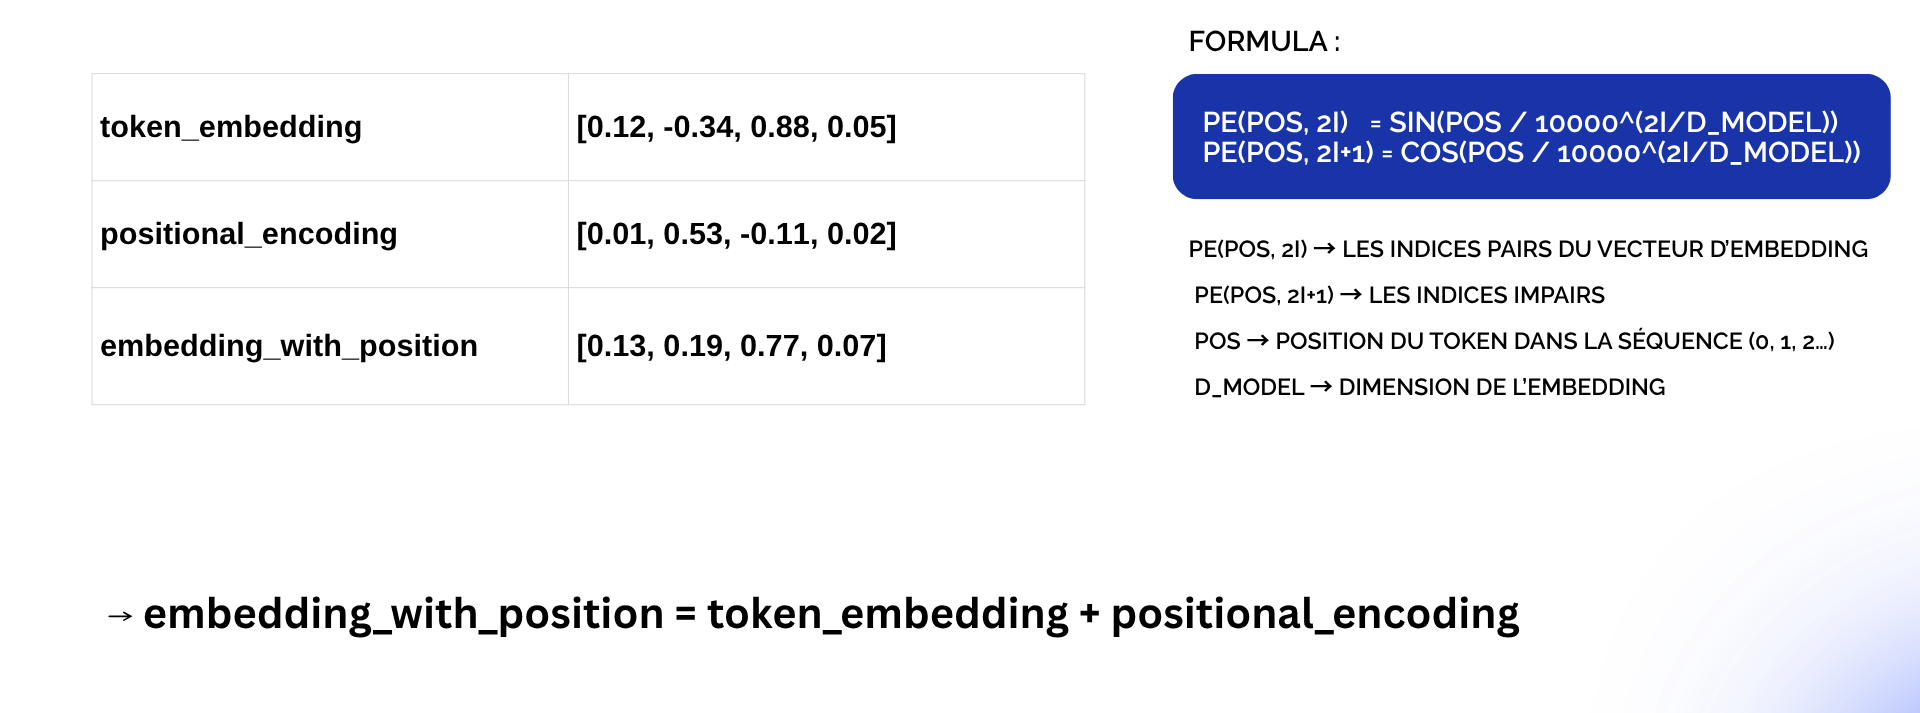
Dans la formule présentée, pos désigne la position du token, i l'indice de dimension et d_model la dimension de l'embedding. Les fonctions sinus et cosinus produisent des motifs différents selon les positions et les dimensions. Le résultat est ajouté au vecteur du token afin que la représentation transmise au Transformer contienne à la fois l'identité du token et sa position.
8Self-Attention : construire une représentation contextuelle
La self-attention est le mécanisme central présenté pour expliquer comment un Transformer tient compte du contexte. À partir de la représentation d'un token, le modèle calcule trois projections : Query (Q), Key (K) et Value (V). Les interactions entre Query et Key servent à mesurer la pertinence des autres tokens ; après normalisation, ces scores deviennent des poids d'attention. Une somme pondérée des Value produit alors une nouvelle représentation contextuelle.
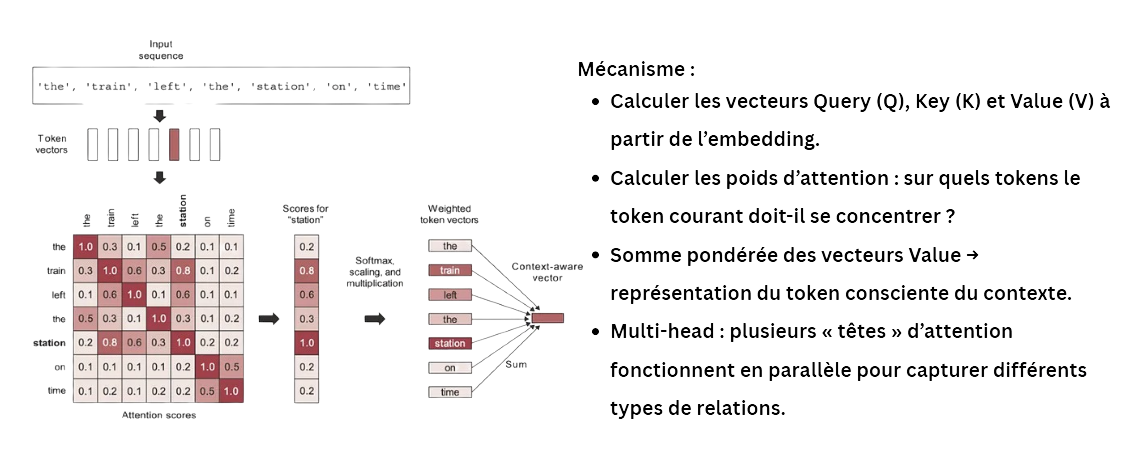
Query (Q) : ce que la position courante cherche dans le contexte.
Key (K) : information utilisée pour déterminer la compatibilité avec une Query.
Value (V) : contenu agrégé selon les poids d'attention.
Multi-head attention : plusieurs têtes travaillent en parallèle afin de capturer différents types de relations.
9Couche linéaire, logits et prédiction du prochain token
Après les blocs Transformer, le modèle doit convertir sa représentation interne en scores associés au vocabulaire. La présentation résume cette étape par une couche linéaire : logits = embedding × W + b. La matrice W projette la représentation vers un espace de taille vocab_size et le biais b ajuste les scores.
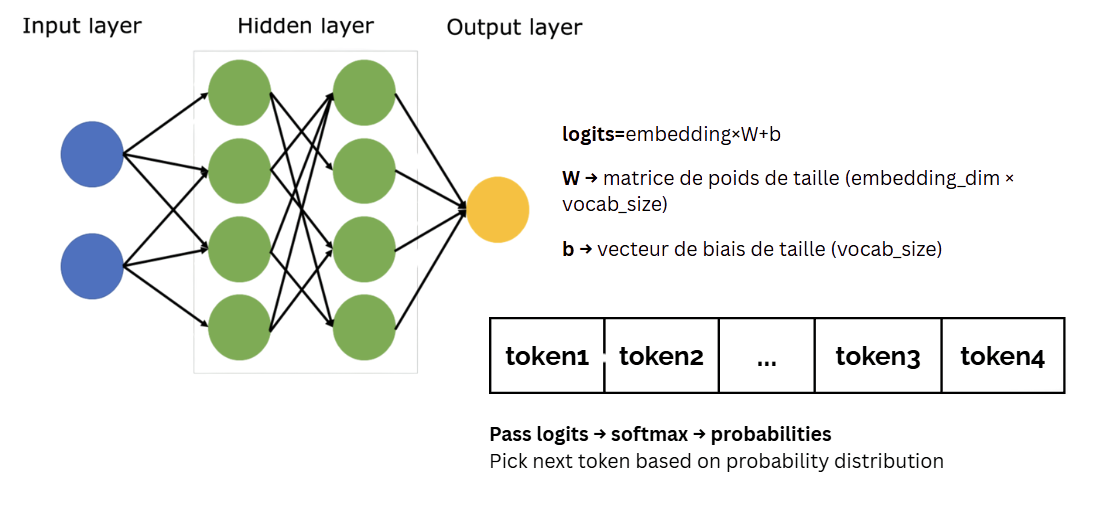
Les logits sont transformés en distribution de probabilités, typiquement via softmax. Le système choisit ensuite le prochain token selon une stratégie d'échantillonnage (greedy, top-k, nucleus, etc.). La présentation illustre le passage de représentation interne → logits → probabilités → sélection du token, qui correspond à l'étape finale de génération.
10Cycle de vie d'un LLM
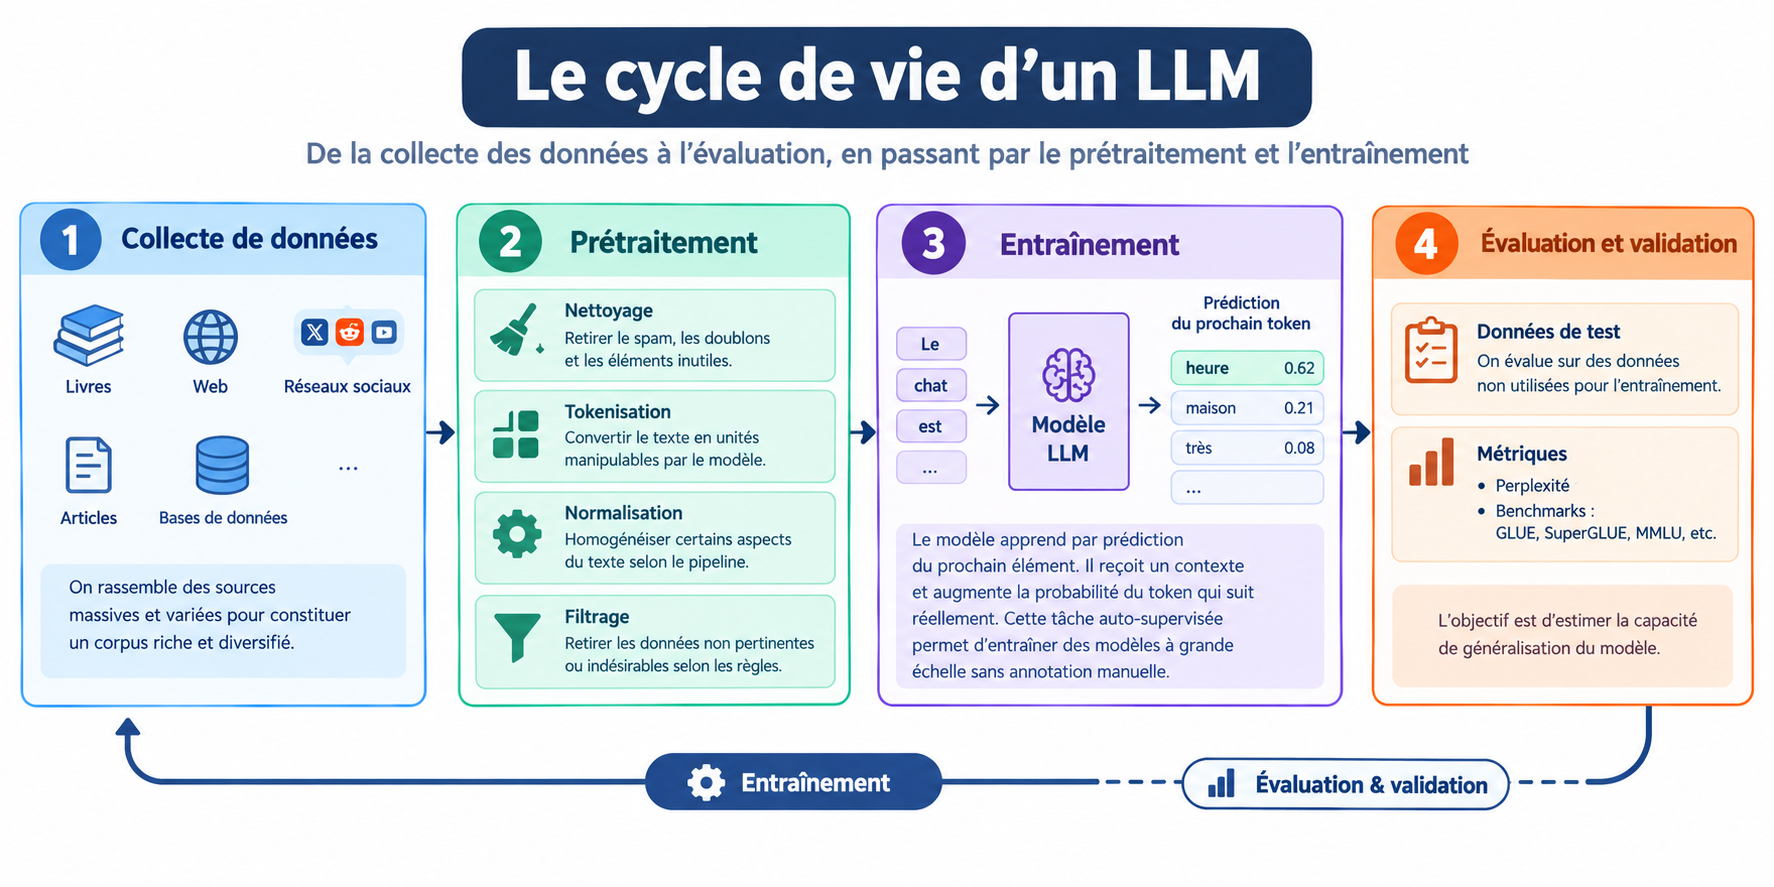
10.1 Collecte de données
Le support évoque des sources massives et variées : livres, web, réseaux sociaux, etc. L'objectif est de constituer un corpus suffisamment riche pour exposer le modèle à une grande diversité de structures et de thèmes.
10.2 Prétraitement
Nettoyage : retirer le spam, les doublons et les éléments inutiles.
Tokenisation : convertir le texte en unités manipulables par le modèle.
Normalisation : homogénéiser certains aspects du texte selon le pipeline.
Filtrage : retirer les données non pertinentes ou indésirables selon les règles définies.
10.3 Entraînement
Le support décrit l'apprentissage par prédiction du prochain élément. Pour un modèle causal, le système reçoit un contexte et apprend à augmenter la probabilité du token qui le suit réellement. Cette tâche auto-supervisée permet d'entraîner des modèles à grande échelle sans annotation manuelle.
10.4 Évaluation et validation
Le modèle est évalué sur des données non utilisées pour l'entraînement afin d'estimer sa capacité de généralisation. La présentation cite la perplexité, une métrique couramment employée en modélisation du langage, et mentionne des benchmarks comme GLUE, SuperGLUE, MMLU, etc.
11Fine-tuning et adaptation
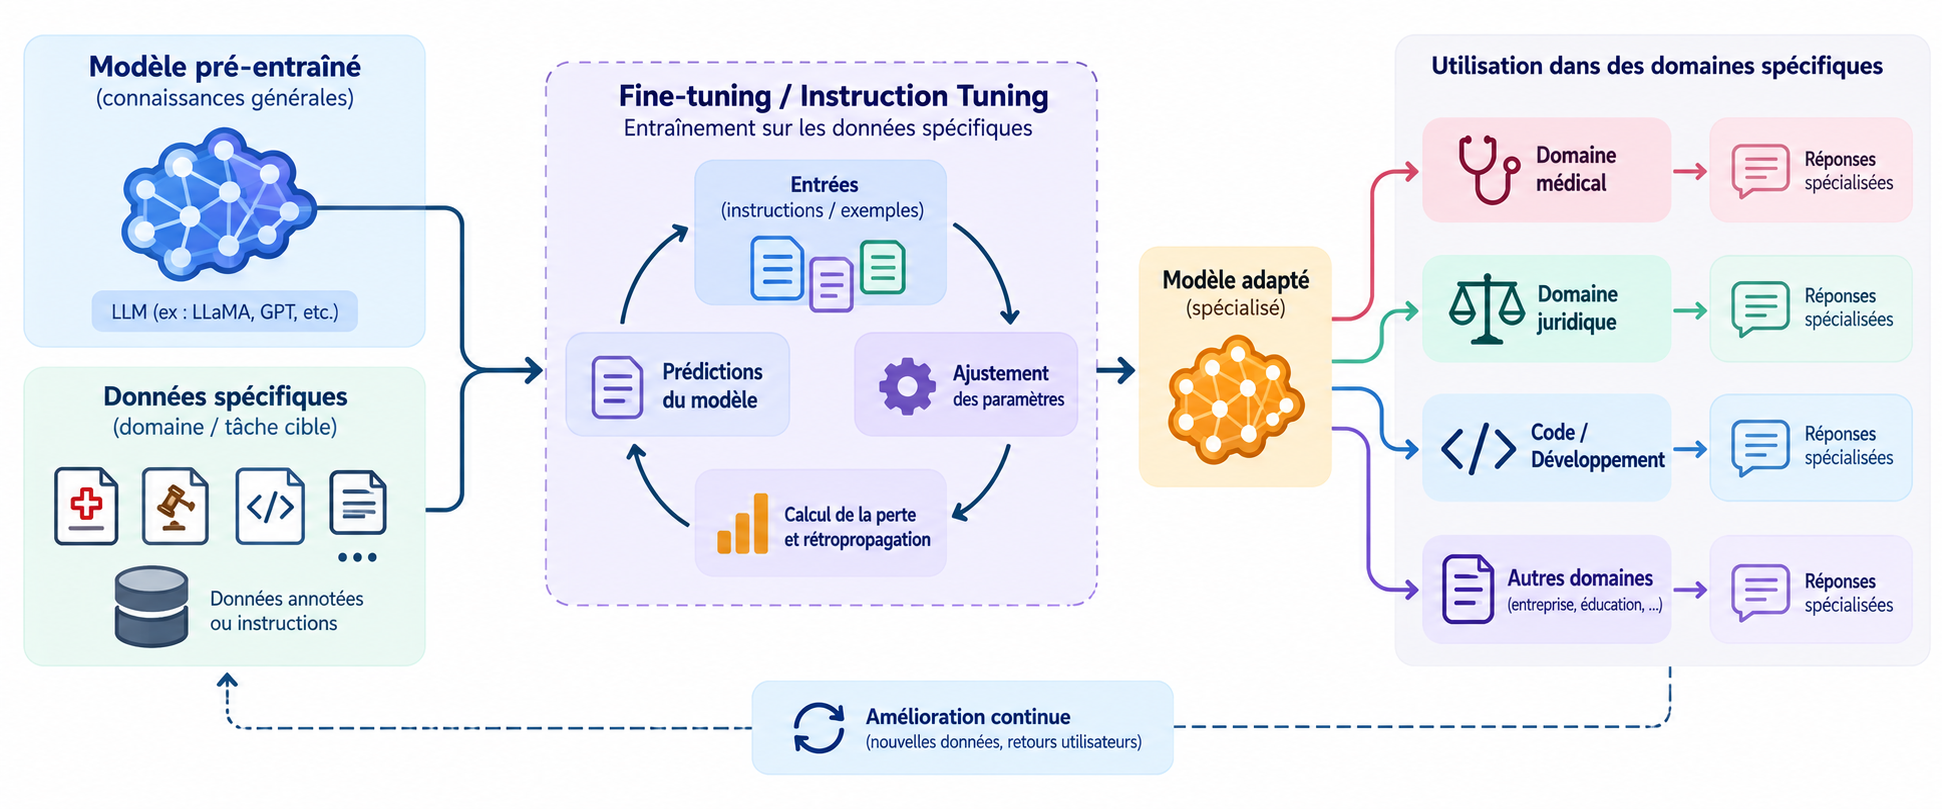
Après le pré-entraînement général, un modèle peut être adapté à un domaine ou à une tâche spécifique. La présentation donne des exemples comme le médical, le juridique ou le code. Des techniques de fine-tuning ou d'instruction tuning permettent d'aligner le comportement du modèle sur des objectifs plus précis.
12Déploiement et utilisation dans le monde réel
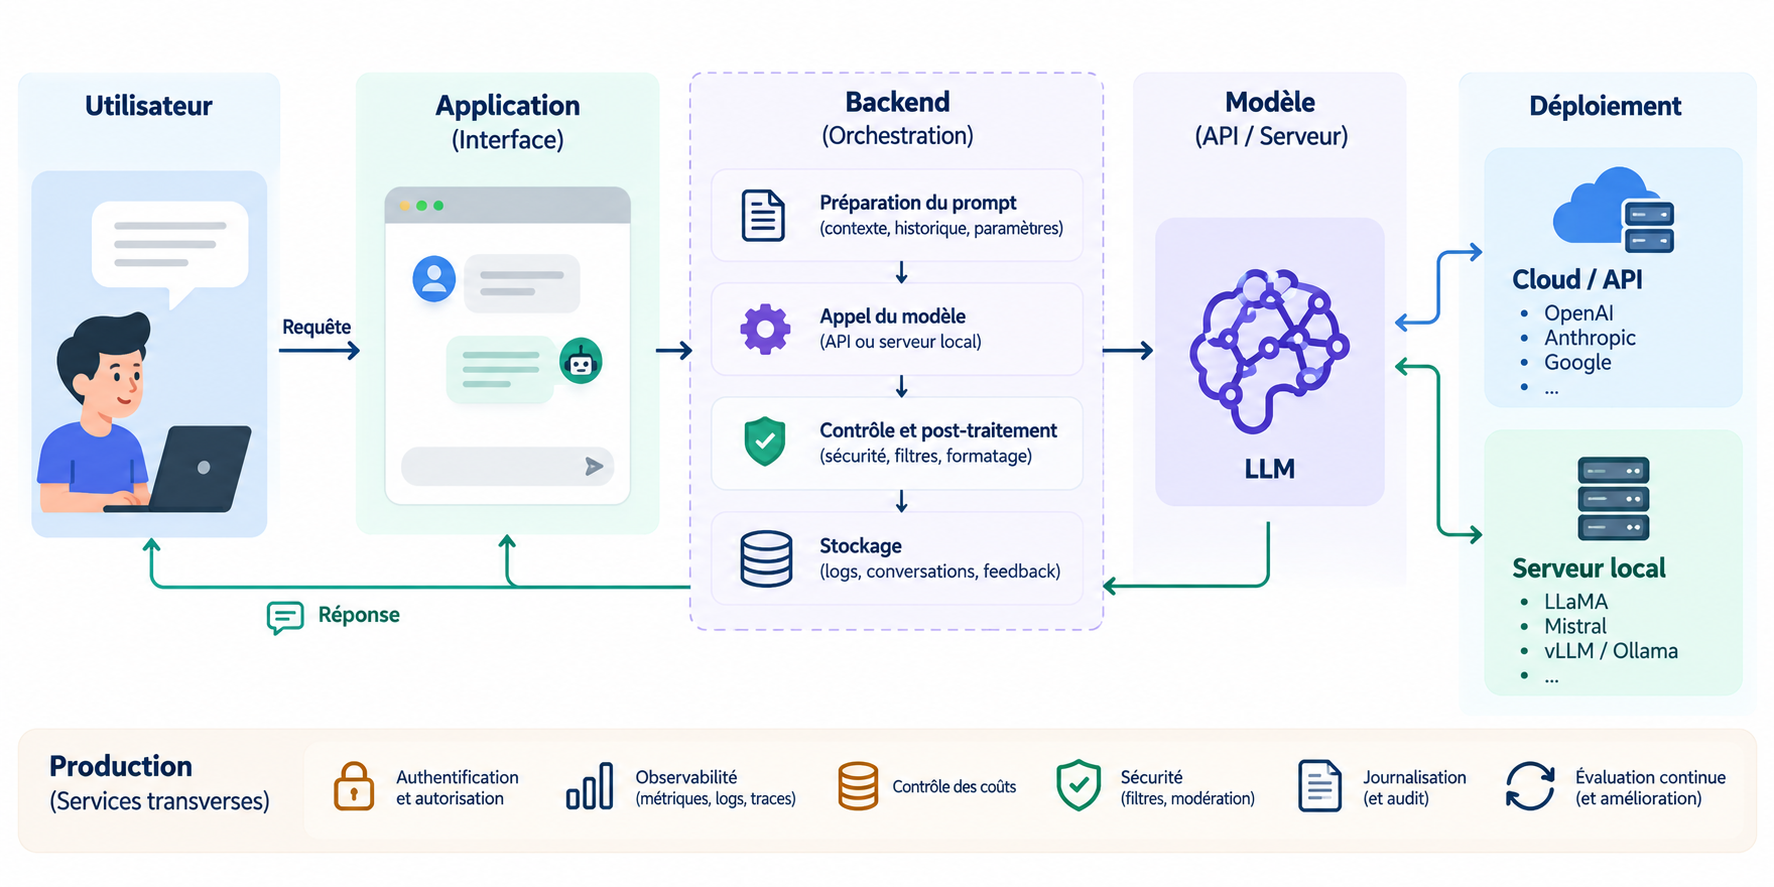
Une fois entraîné et validé, le modèle doit être rendu accessible. La présentation mentionne la mise à disposition via des API telles que celles d'OpenAI, ou bien un déploiement local ou cloud.
Architecture d'utilisation typique
Une application collecte la demande de l'utilisateur.
Le backend prépare le prompt, le contexte et les paramètres d'inférence.
Une API ou un serveur de modèle exécute le LLM.
La réponse est contrôlée, formatée et renvoyée à l'interface.
En production, on ajoute souvent authentification, observabilité, contrôle des coûts, sécurité, journalisation et évaluation continue.
13Évaluation des LLM : performance, qualité et sécurité
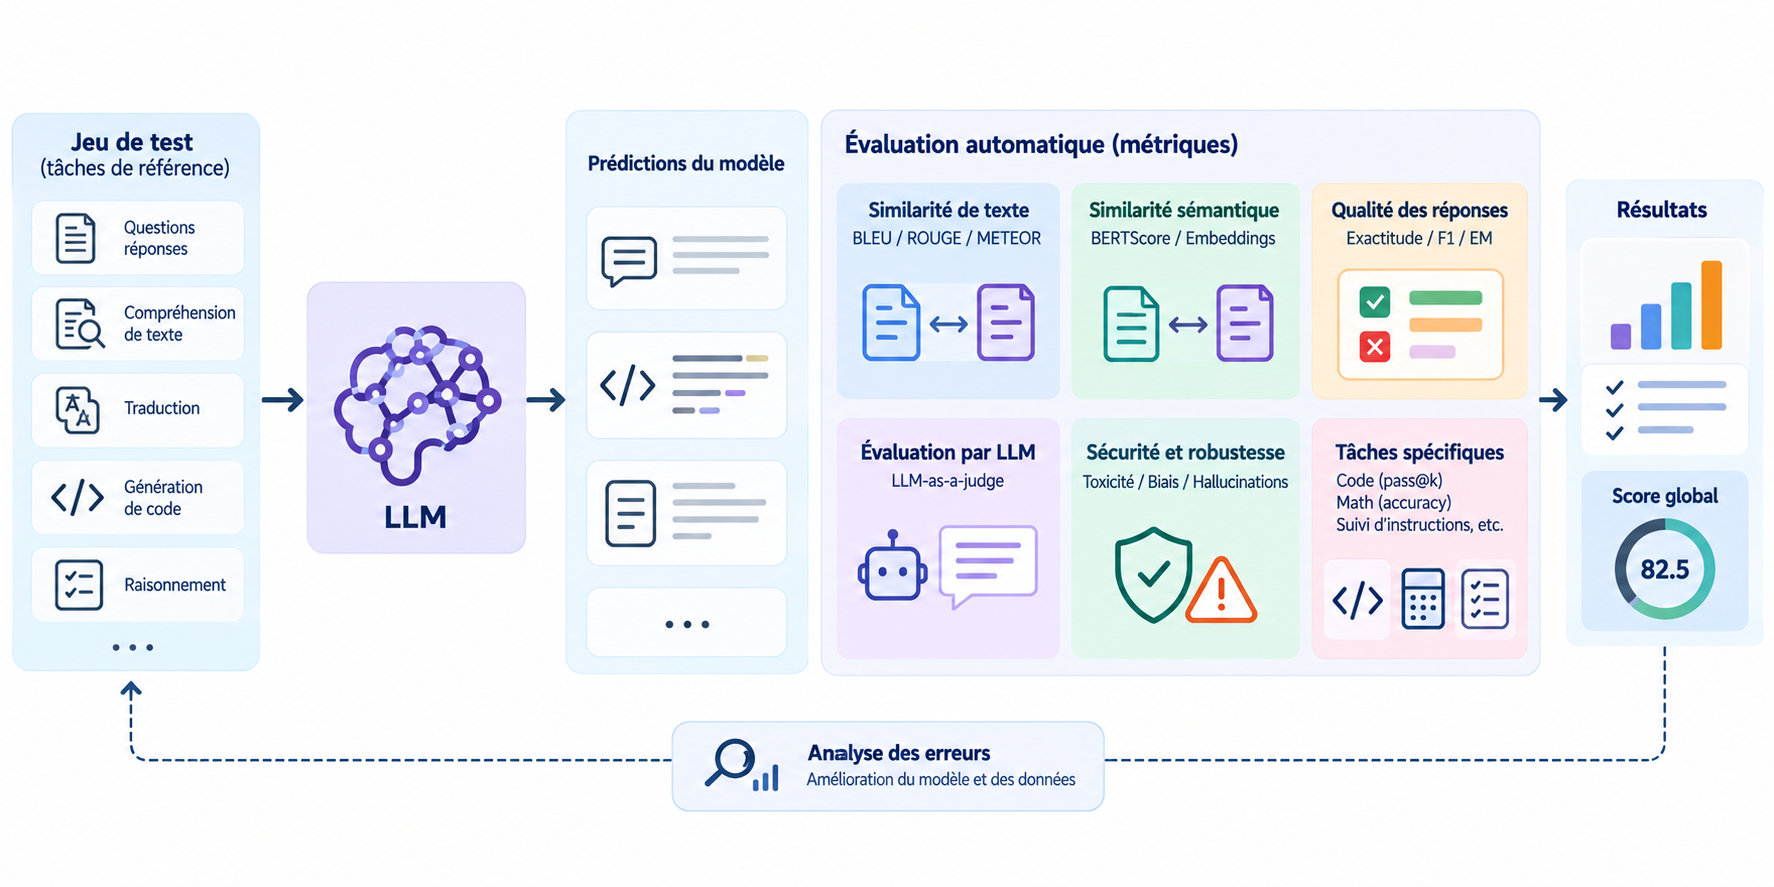
L'évaluation d'un LLM combine des approches quantitatives et qualitatives. Les métriques automatiques permettent de mesurer les performances du modèle sur des tâches définies, par exemple l'exactitude, la similarité des réponses, le respect des instructions ou les performances sur des benchmarks. Cependant, ces scores ne suffisent pas à garantir la qualité réelle du système. Une évaluation qualitative complète donc ces mesures en vérifiant la cohérence, la pertinence et la fluidité des réponses, ainsi que leur sécurité face aux hallucinations ou aux contenus dangereux. L'évaluation prend également en compte la durabilité, notamment les coûts de calcul et l'efficacité du modèle, ainsi que la transparence sur ses limites, ses méthodes d'évaluation et ses conditions d'utilisation.