1Fondamentaux du Machine Learning
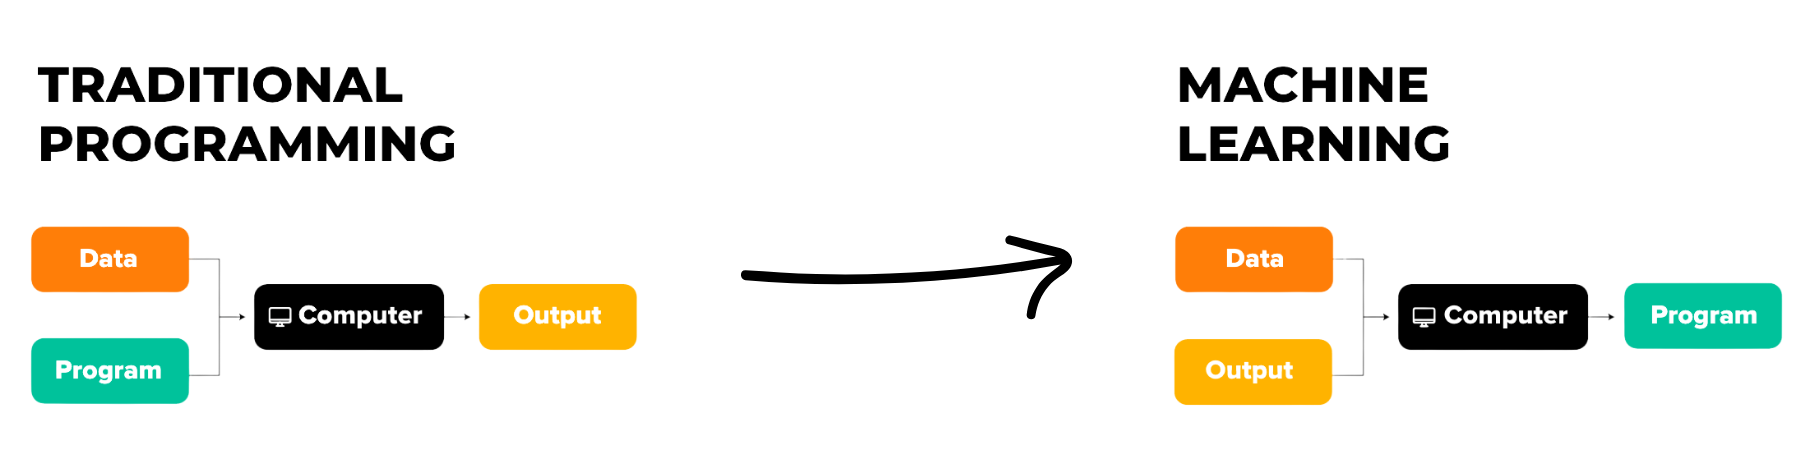
Le Machine Learning est l'étude de systèmes qui s'améliorent grâce à l'expérience et aux données. La différence fondamentale avec la programmation traditionnelle est que, au lieu d'écrire explicitement chaque règle qui transforme les entrées en sorties, on fournit des exemples pour que le système puisse apprendre des relations utiles et faire ensuite des prédictions ou des décisions.
1.1Les Trois Grandes Familles d'Apprentissage
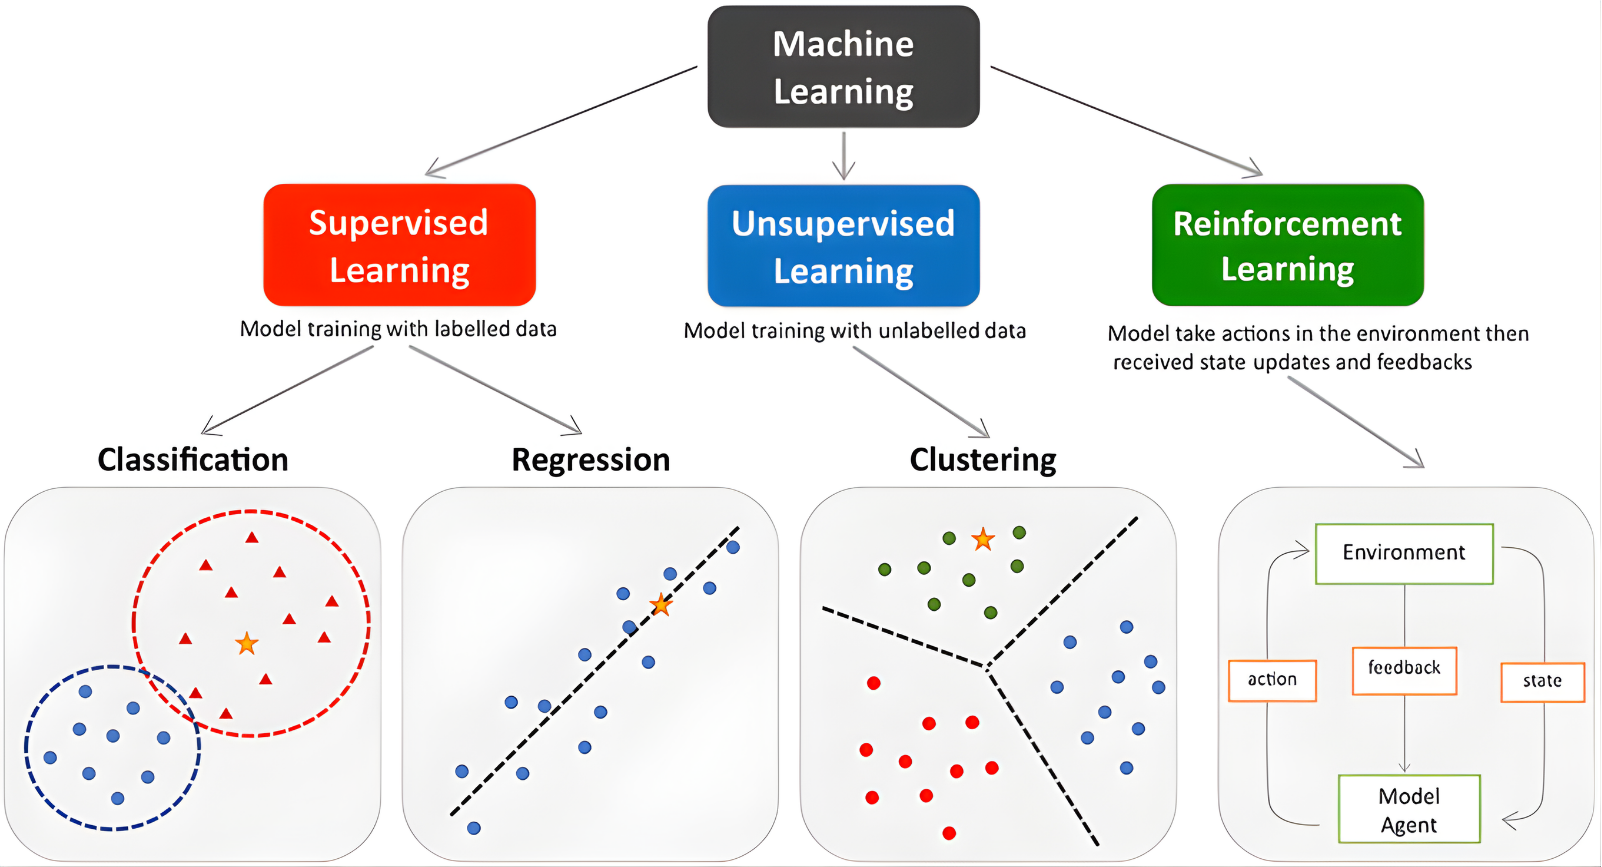
On distingue trois grandes familles : l'apprentissage supervisé, l'apprentissage non supervisé et l'apprentissage par renforcement. Cette classification fournit une carte générale pour comprendre comment les différentes tâches de Machine Learning sont organisées.
- Apprentissage supervisé : le système apprend à partir de données associées à une réponse attendue. Les tâches typiques incluent la classification et la régression.
- Apprentissage non supervisé : les données n'ont pas d'étiquette cible ; l'objectif est de découvrir une structure telle que des groupes, des patterns ou des représentations de dimension réduite.
- Apprentissage par renforcement : un agent agit dans un environnement, reçoit des retours et ajuste son comportement grâce à des interactions répétées.
1.2Comment Lire la Suite de Ce Chapitre
Avant d'étudier les algorithmes individuels, ce chapitre se concentre sur les concepts partagés par presque tous les workflows de Machine Learning : les données, les signaux d'apprentissage, la validation, l'optimisation, la généralisation, l'évaluation, la reproductibilité et la surveillance.
1.3Le Cycle de Vie d'un Projet Machine Learning
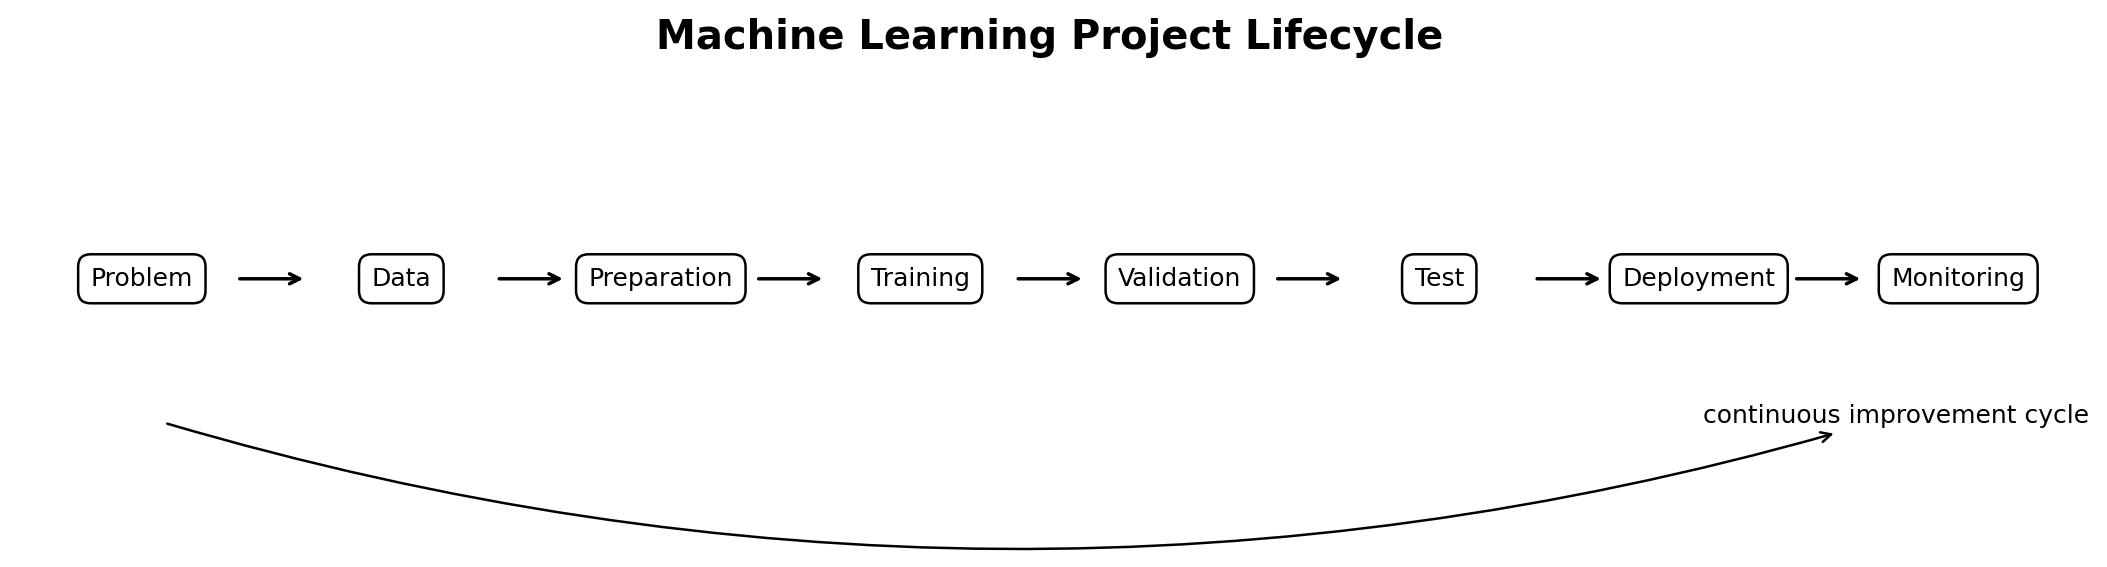
Avant d'aborder les algorithmes, il est important de comprendre qu'un projet de Machine Learning est un processus complet et itératif. Le travail commence par la formulation du problème et se poursuit bien au-delà de l'entraînement. Chaque étape peut affecter la qualité finale du système.
- Définition du problème : spécifier l'objectif, la sortie attendue, les contraintes et le coût des erreurs.
- Collecte des données : rassembler des exemples suffisamment pertinents et représentatifs.
- Exploration : comprendre les distributions, les valeurs manquantes, les anomalies, les doublons et les déséquilibres.
- Préparation : nettoyer, transformer et organiser les variables sans introduire de fuite d'information.
- Entraînement : apprendre les paramètres internes à partir des données d'entraînement.
- Validation : comparer les choix et ajuster les hyperparamètres.
- Test : produire une estimation finale sur des données réellement non vues.
- Déploiement et surveillance : suivre les performances et réagir quand les données changent.
1.4Données : Observations, Caractéristiques et Cible
Un jeu de données peut être vu comme une collection d'observations. Chaque observation est décrite par plusieurs caractéristiques. En apprentissage supervisé, une cible représente la réponse que le système doit apprendre à prédire.
| Concept | Explication |
|---|---|
| Observation | Un exemple individuel : un client, une transaction, une image, une mesure, etc. |
| Caractéristique | Information décrivant l'observation : âge, montant, surface, fréquence, catégorie, etc. |
| Cible | La réponse attendue en apprentissage supervisé. |
| Jeu de données | L'ensemble des observations utilisées pour l'analyse et l'apprentissage. |
| Dimension | Le nombre de caractéristiques utilisées pour représenter une observation. |
1.5Qualité et Représentativité des Données
Un système de Machine Learning apprend de ce que les données lui montrent. Si les données contiennent des erreurs systématiques, des groupes manquants ou des étiquettes incorrectes, le processus d'apprentissage peut reproduire ces problèmes. La préparation des données est donc une partie fondamentale du workflow.
- Complétude : mesurer et comprendre les valeurs manquantes.
- Cohérence : détecter les formats incompatibles, les contradictions et les doublons.
- Exactitude : vérifier que les valeurs décrivent correctement la réalité.
- Représentativité : couvrir les situations qui se produiront après le déploiement.
- Fraîcheur : éviter les données obsolètes lorsque le phénomène sous-jacent change.
- Qualité des étiquettes : vérifier la cohérence des réponses attendues dans les tâches supervisées.
1.6Entraînement, Validation et Test
Pour mesurer honnêtement la généralisation, les données sont divisées en ensembles ayant des rôles différents. Les données d'entraînement servent à apprendre les paramètres, les données de validation permettent de prendre des décisions de développement, et les données de test sont conservées isolées jusqu'à l'évaluation finale.
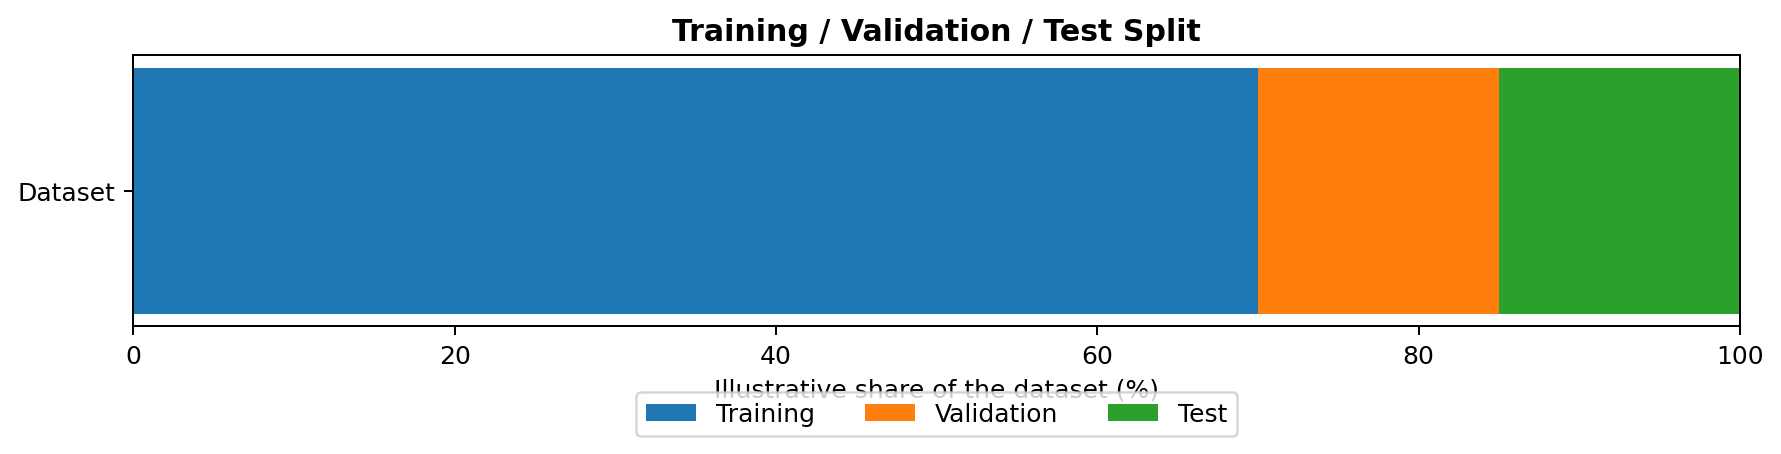
Lorsque les données sont limitées, la validation croisée peut être utilisée : plusieurs découpages sont évalués successivement pour obtenir une estimation de performance plus robuste et réduire la dépendance à un découpage particulier.
1.7Paramètres et Hyperparamètres
Les paramètres et les hyperparamètres jouent des rôles différents. Les paramètres sont appris automatiquement à partir des données pendant l'entraînement, tandis que les hyperparamètres contrôlent le comportement de l'apprentissage et sont sélectionnés par le praticien ou une procédure d'ajustement.
| Élément | Paramètres | Hyperparamètres |
|---|---|---|
| Origine | Appris pendant l'entraînement | Choisis avant/autour de l'entraînement |
| Rôle | Représentent ce que le système a appris | Contrôlent la capacité, la régularisation ou le processus d'apprentissage |
| Ajustement | Optimisation automatique | Validation, recherche par grille, recherche aléatoire, etc. |
1.8Fonctions de Perte et Optimisation
Pour apprendre, le système a besoin d'un signal numérique indiquant si ses prédictions sont bonnes ou mauvaises. Une fonction de perte mesure l'erreur de prédiction, et l'optimisation modifie les paramètres appris pour réduire cette perte au fil des itérations répétées.
- Prédiction : sortie produite par le système.
- Erreur : différence entre la prédiction et le résultat attendu.
- Fonction de perte : règle mathématique utilisée pour quantifier cette erreur.
- Optimisation : procédure qui ajuste les paramètres pour réduire la perte.
- Convergence : le point auquel les améliorations deviennent faibles ou se stabilisent.
Une faible perte d'entraînement seule n'est pas une preuve suffisante de qualité. Les performances doivent rester élevées sur des données qui n'ont pas été utilisées pour l'apprentissage.
1.9Généralisation, Sous-apprentissage et Sur-apprentissage
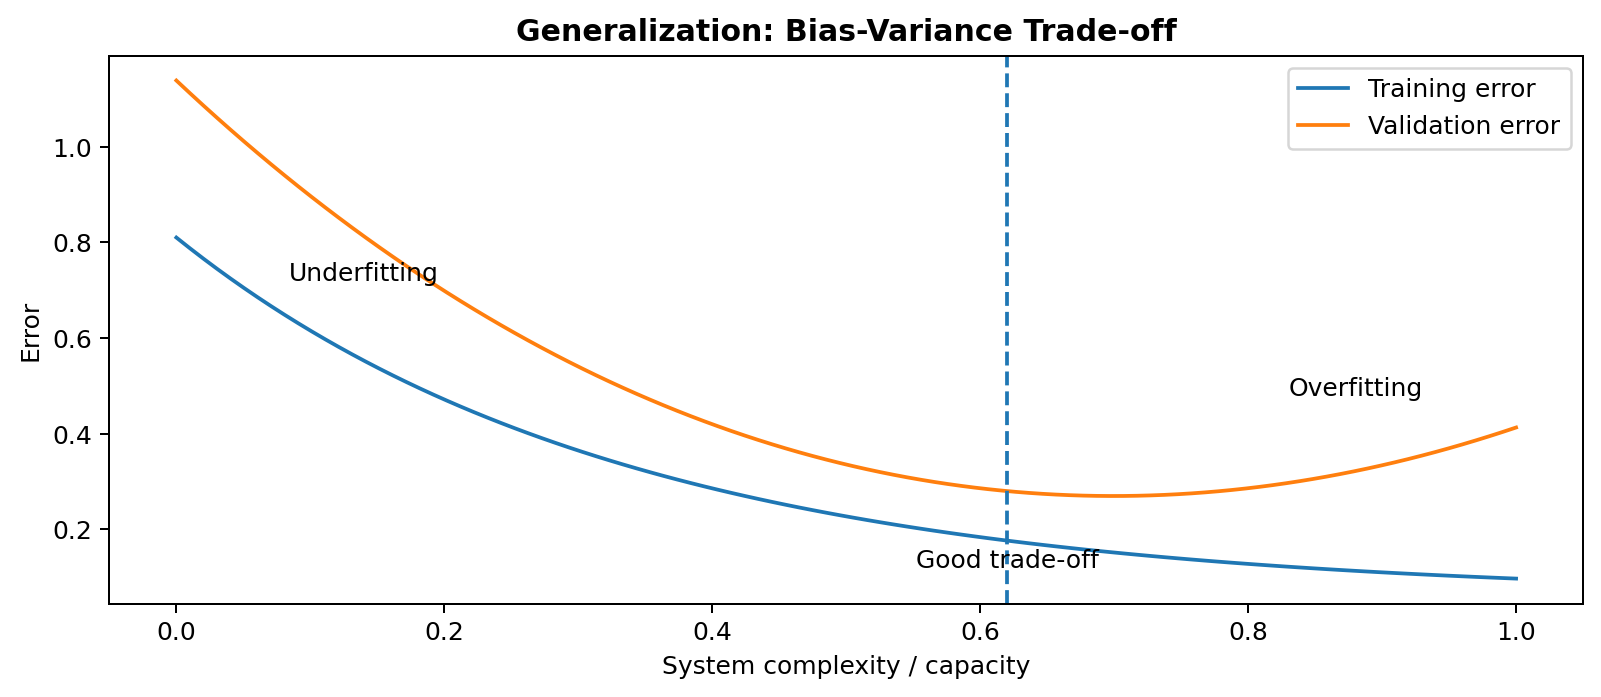
La généralisation est la capacité à bien performer sur de nouvelles données. Le sous-apprentissage se produit quand le système est trop simple pour capturer la structure utile ; le sur-apprentissage se produit quand il s'adapte trop étroitement aux exemples d'entraînement et à leur bruit.
- Sous-apprentissage : le système est trop simple ou insuffisamment entraîné et fait déjà beaucoup d'erreurs sur les données d'entraînement.
- Sur-apprentissage : le système s'adapte trop étroitement aux données d'entraînement, y compris leur bruit, et perd des performances sur de nouvelles données.
- Bon compromis : le système apprend suffisamment du signal utile sans capturer les détails accidentels du jeu d'entraînement.
1.10Le Compromis Biais-Variance
Le biais reflète l'erreur systématique causée par une représentation trop simpliste du problème. La variance reflète une sensibilité excessive à l'échantillon d'entraînement spécifique. Une bonne généralisation nécessite un équilibre utile entre les deux.
- Biais élevé → tendance au sous-apprentissage.
- Variance élevée → tendance au sur-apprentissage.
- L'objectif n'est pas seulement de minimiser l'erreur d'entraînement, mais de minimiser l'erreur sur de nouvelles données.
1.11Mesurer les Performances
Une métrique résume la qualité des prédictions. La métrique correcte dépend de la tâche et du coût réel des différentes erreurs. Examiner plusieurs métriques complémentaires est souvent plus informatif que de se fier à un seul score.
| Type de tâche | Métriques courantes | Interprétation générale |
|---|---|---|
| Classification | Accuracy, Précision, Rappel, F1-score | Mesurent différents aspects de la qualité des classes prédites. |
| Régression | MAE, MSE, RMSE, R² | Mesurent l'écart entre les valeurs prédites et réelles. |
1.12La Matrice de Confusion
Pour la classification binaire, une matrice de confusion montre la nature des erreurs plutôt que leur nombre total. Elle sépare les vrais positifs, les vrais négatifs, les faux positifs et les faux négatifs.
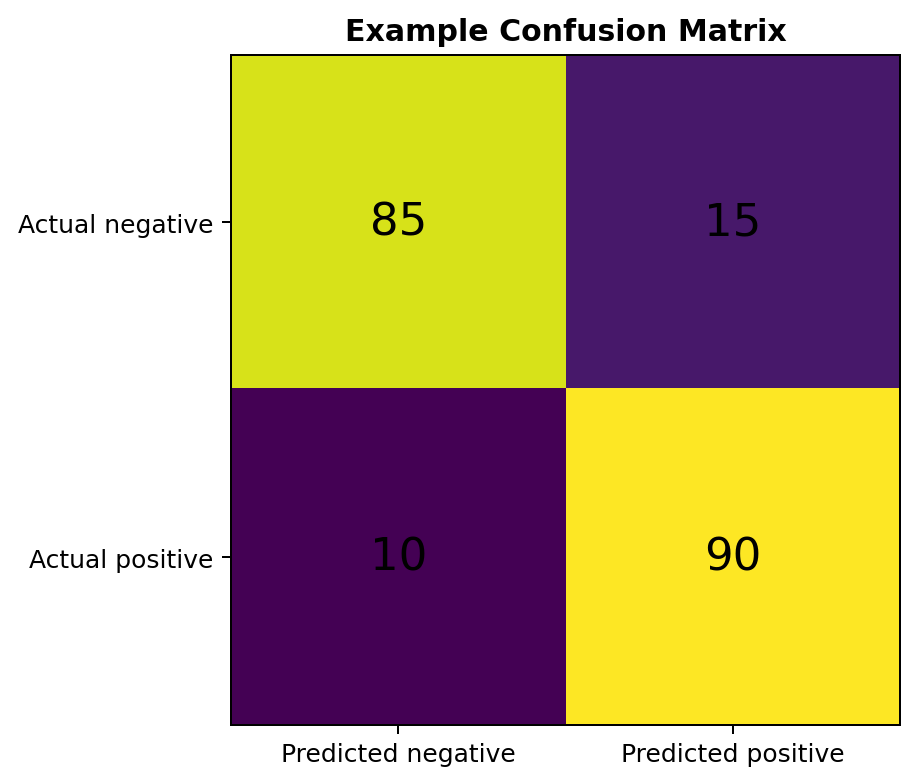
- Vrai positif : un cas positif est correctement détecté.
- Vrai négatif : un cas négatif est correctement rejeté.
- Faux positif : le système prédit positif alors que le cas est réellement négatif.
- Faux négatif : le système manque un cas réellement positif.
1.13Fuite de Données
La fuite de données se produit lorsque des informations qui ne devraient pas être disponibles au moment de la prédiction influencent l'entraînement ou la validation. Elle peut créer des résultats de développement irréalistes qui échouent en production.
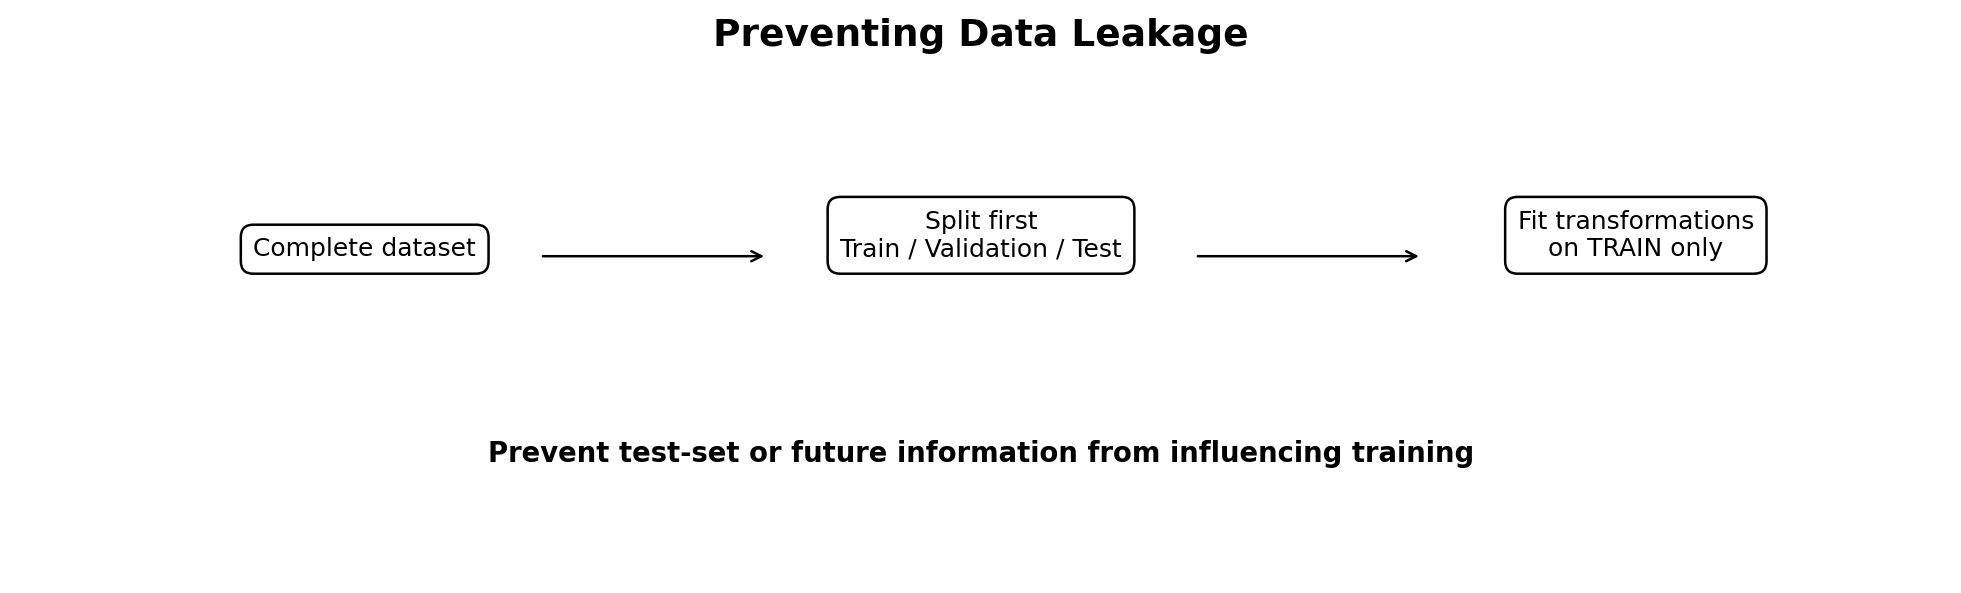
- Diviser les données train/validation/test avant d'appliquer des transformations qui apprennent des statistiques globales.
- Ajuster les transformations uniquement sur les données d'entraînement.
- Ne pas utiliser une variable créée après l'événement prédit.
- Pour les séries temporelles, préserver l'ordre chronologique et ne jamais apprendre du futur.
1.14Prétraitement et Ingénierie des Caractéristiques
Les données brutes sont rarement prêtes pour une utilisation directe. Le prétraitement crée une représentation cohérente, tandis que l'ingénierie des caractéristiques crée ou transforme des variables pour faciliter l'apprentissage des informations utiles.
- Gestion des valeurs manquantes.
- Gestion des doublons et des anomalies.
- Encodage des variables catégorielles.
- Normalisation ou standardisation quand l'échelle affecte l'apprentissage.
- Création de nouvelles caractéristiques pertinentes.
- Suppression des caractéristiques inutiles, redondantes ou indisponibles en production.
1.15Données Déséquilibrées
Un jeu de données est déséquilibré lorsqu'une classe est beaucoup plus fréquente qu'une autre. Dans cette situation, une accuracy globale élevée peut masquer de très mauvaises performances sur la classe minoritaire.
- Examiner la distribution des classes.
- Utiliser la précision, le rappel, le F1-score et la matrice de confusion.
- Préserver des proportions représentatives des classes dans les découpages lorsque c'est approprié.
- Appliquer les techniques de rééquilibrage uniquement aux données d'entraînement pour ne pas contaminer l'évaluation.
1.16Reproductibilité des Expériences
Un résultat de Machine Learning doit être reproductible. La reproductibilité rend les expériences comparables, aide à expliquer les différences de performance et permet de revenir à des versions antérieures.
- Versionner le code et, si possible, les données.
- Enregistrer les hyperparamètres de chaque expérience.
- Enregistrer les métriques et les conditions d'évaluation.
- Fixer les graines aléatoires lorsque c'est approprié.
- Documenter les étapes de préparation et les transformations.
1.17Déploiement, Surveillance et Dérive
Les données du monde réel changent avec le temps. Un système qui performe bien aujourd'hui peut se dégrader plus tard, la surveillance est donc nécessaire pour détecter la dérive des données, la dérive des concepts et la baisse des performances.
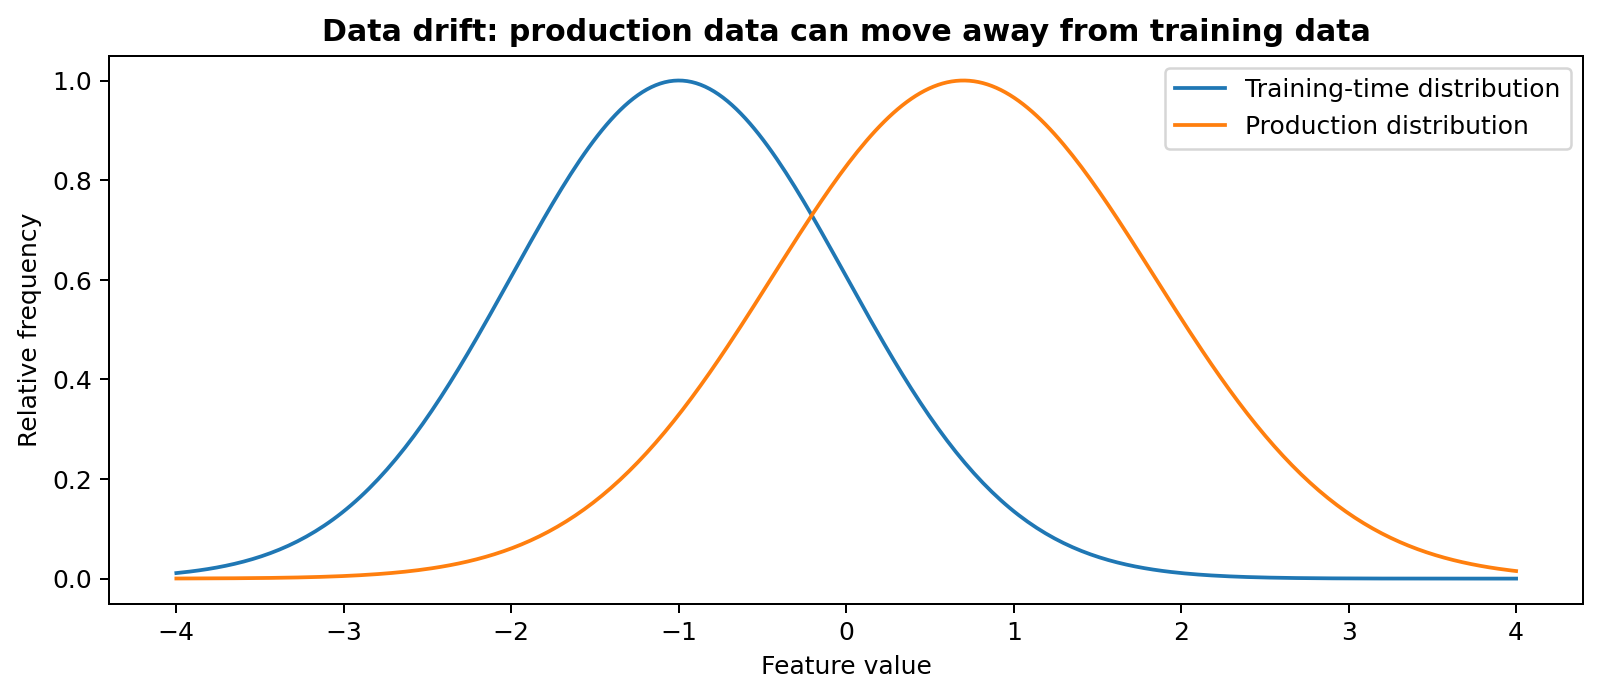
- Dérive des données : la distribution des caractéristiques d'entrée change.
- Dérive des concepts : la relation entre les entrées et la cible change.
- Surveillance : suivi des performances, des distributions, des erreurs et des volumes.
- Réentraînement : mise à jour du système avec des données plus récentes quand nécessaire.
1.18Bonnes Pratiques Fondamentales
- Comprendre le contexte métier/problème avant d'expérimenter.
- Explorer les données avant de les transformer.
- Construire une baseline simple comme point de référence.
- Séparer clairement entraînement, validation et test.
- Éviter la fuite de données.
- Choisir les métriques en fonction du coût réel des erreurs.
- Documenter les expériences pour assurer la reproductibilité.
- Analyser la généralisation plutôt que les performances d'entraînement seules.
- Surveiller le système après le déploiement.
Conclusion : les modèles viennent après ces fondamentaux. Une méthodologie saine, des données fiables et une évaluation honnête sont les fondations d'un projet de Machine Learning robuste.
1.19Qualité des Données en Pratique
La qualité des données est multidimensionnelle. Un jeu de données peut être volumineux mais rester inadapté à l'apprentissage s'il est incomplet, incohérent, mal étiqueté, biaisé ou différent de l'environnement dans lequel le système opérera.
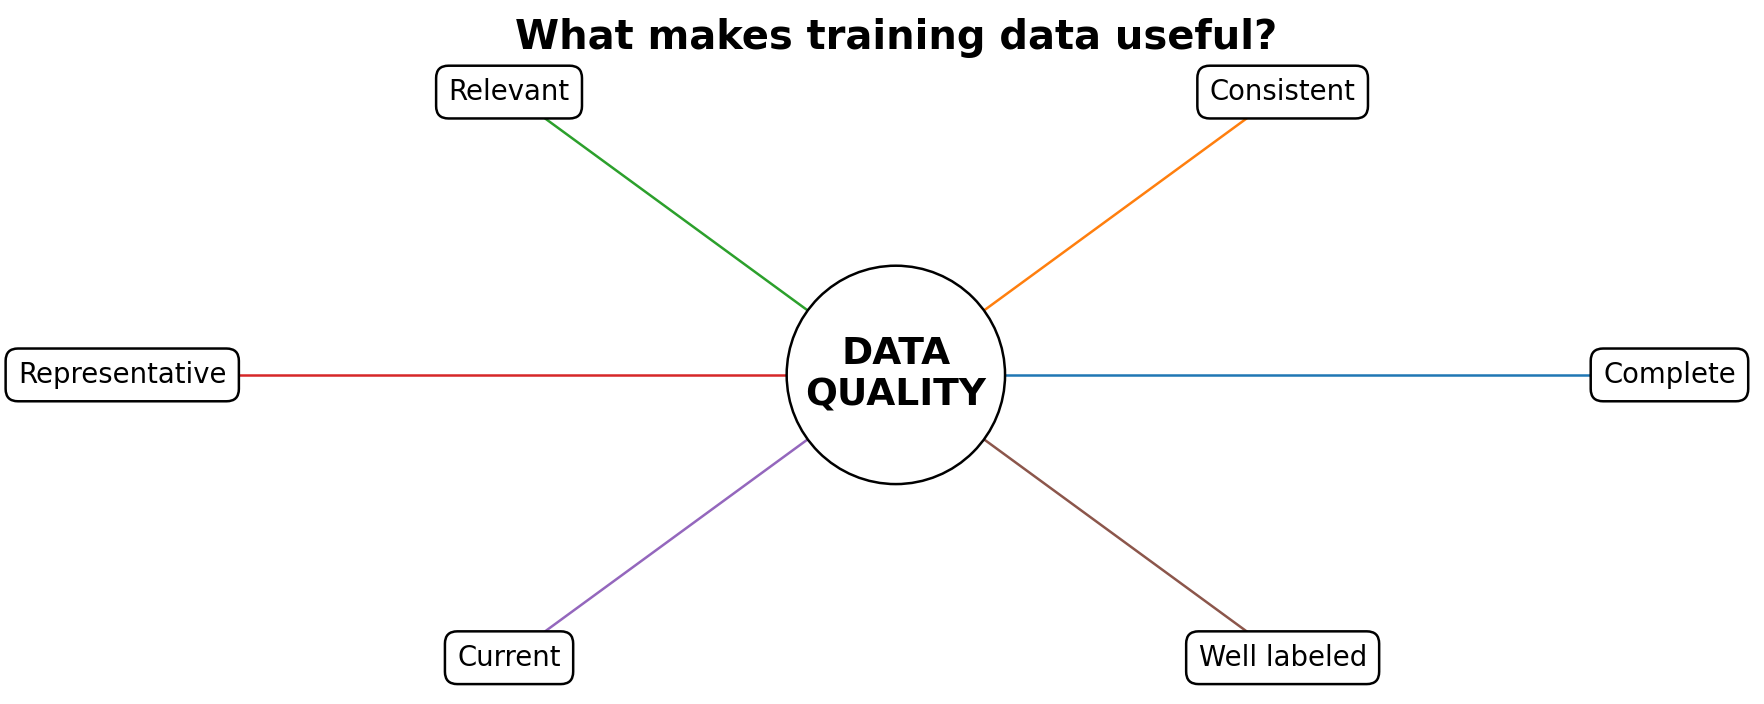
- Complétude : comprendre pourquoi les valeurs sont manquantes plutôt que de les remplir automatiquement.
- Cohérence : utiliser des unités, formats, identifiants et définitions de catégories stables.
- Représentativité : s'assurer que les populations importantes et les conditions de fonctionnement sont présentes.
- Fiabilité des étiquettes : les étiquettes bruitées limitent ce que l'apprentissage supervisé peut apprendre.
- Actualité : les données doivent refléter l'environnement où les prédictions seront faites.
- Documentation : enregistrer la provenance des données, comment elles ont été collectées et ce que signifie chaque champ.
1.20Validation Croisée
La validation croisée fournit une estimation plus robuste des performances quand un seul découpage train/validation peut être trop dépendant du hasard. Dans la validation croisée k-fold, les données sont divisées en k parties. L'expérience est répétée k fois, en utilisant une partie différente pour la validation à chaque fois et en moyennant les résultats.
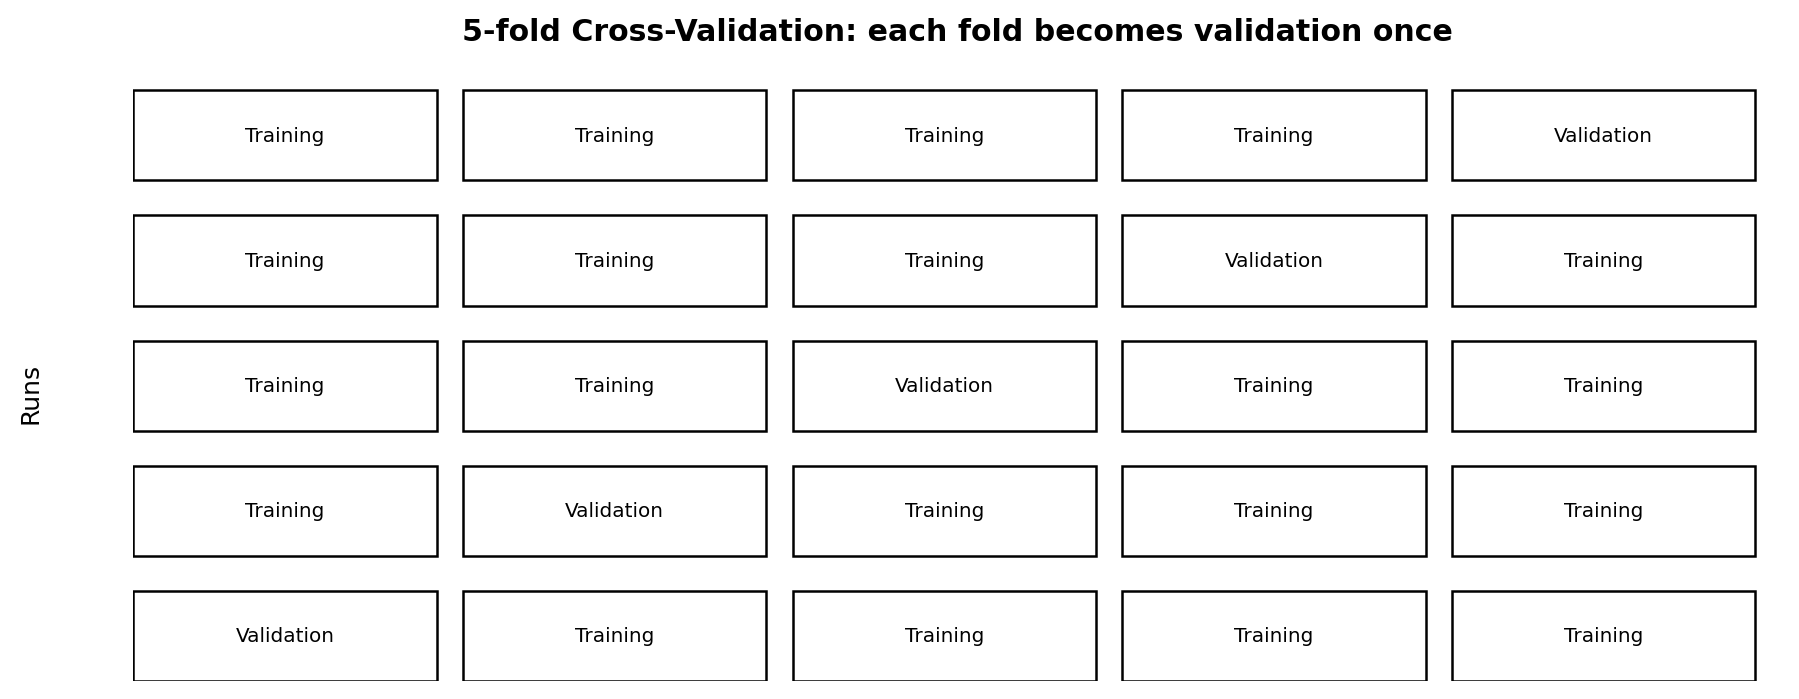
Pour les données de séries temporelles, le découpage aléatoire k-fold ordinaire peut être inapproprié car il peut permettre à des informations futures d'influencer le passé. La validation temporelle doit préserver l'ordre chronologique.
1.21Construire un Pipeline de Prétraitement Sécurisé
Le prétraitement doit être reproductible et ne doit pas apprendre d'informations à partir des données de validation ou de test. Les statistiques telles que les moyennes, les écarts-types, les vocabulaires de catégories ou les valeurs d'imputation doivent être apprises à partir des données d'entraînement puis réutilisées sans modification sur les données ultérieures.
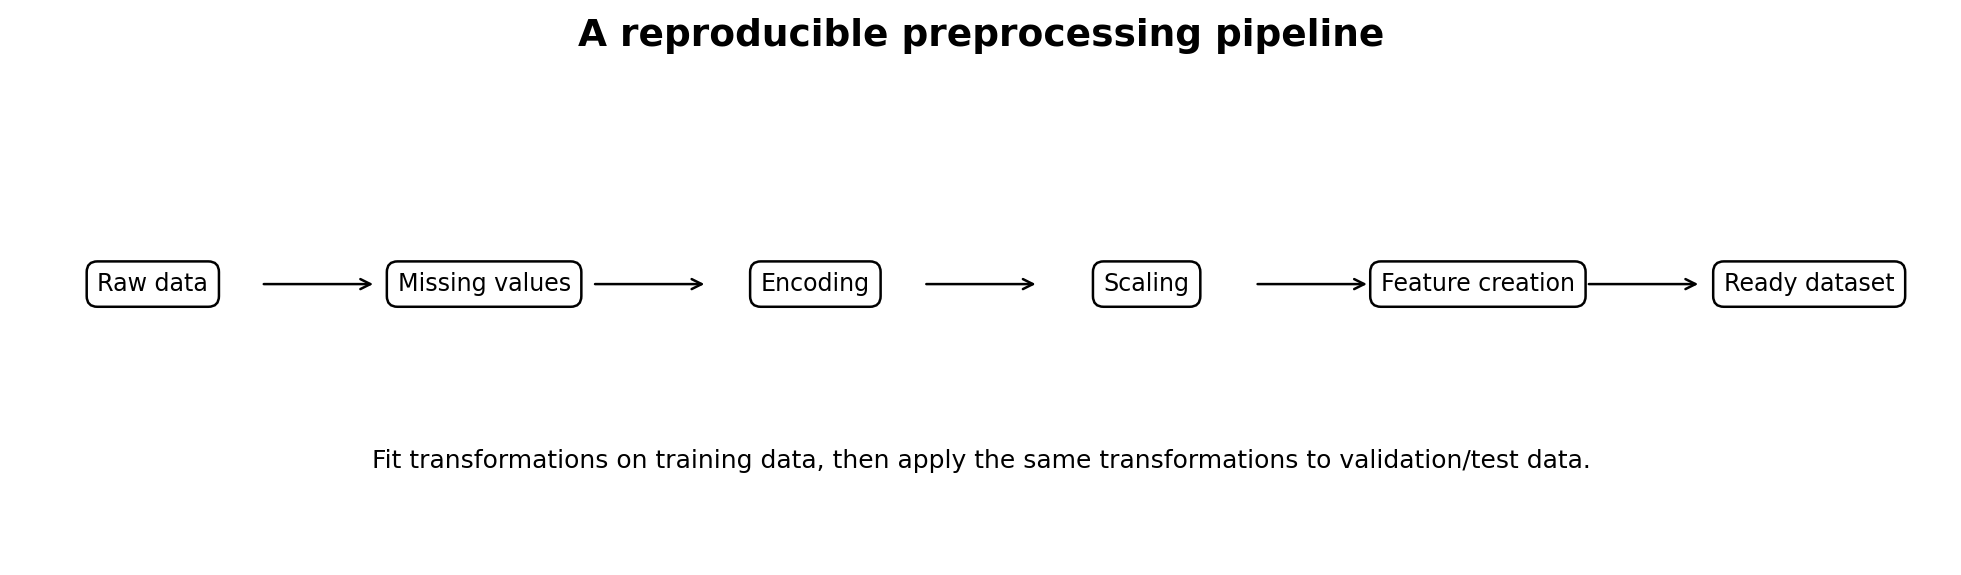
- Séparer les données avant d'ajuster les transformations apprises.
- Ajuster les étapes de prétraitement uniquement sur les données d'entraînement.
- Appliquer les transformations ajustées aux données de validation, de test et de production.
- Conserver les étapes de prétraitement et de prédiction versionnées ensemble.
- Vérifier que chaque caractéristique sera réellement disponible au moment de la prédiction.
1.22Comprendre le Déséquilibre des Classes
Le déséquilibre des classes est courant dans la détection de fraude, la détection de pannes, le dépistage médical et autres problèmes d'événements rares. Un système qui prédit toujours la classe majoritaire peut atteindre une accuracy élevée tout en étant pratiquement inutile.
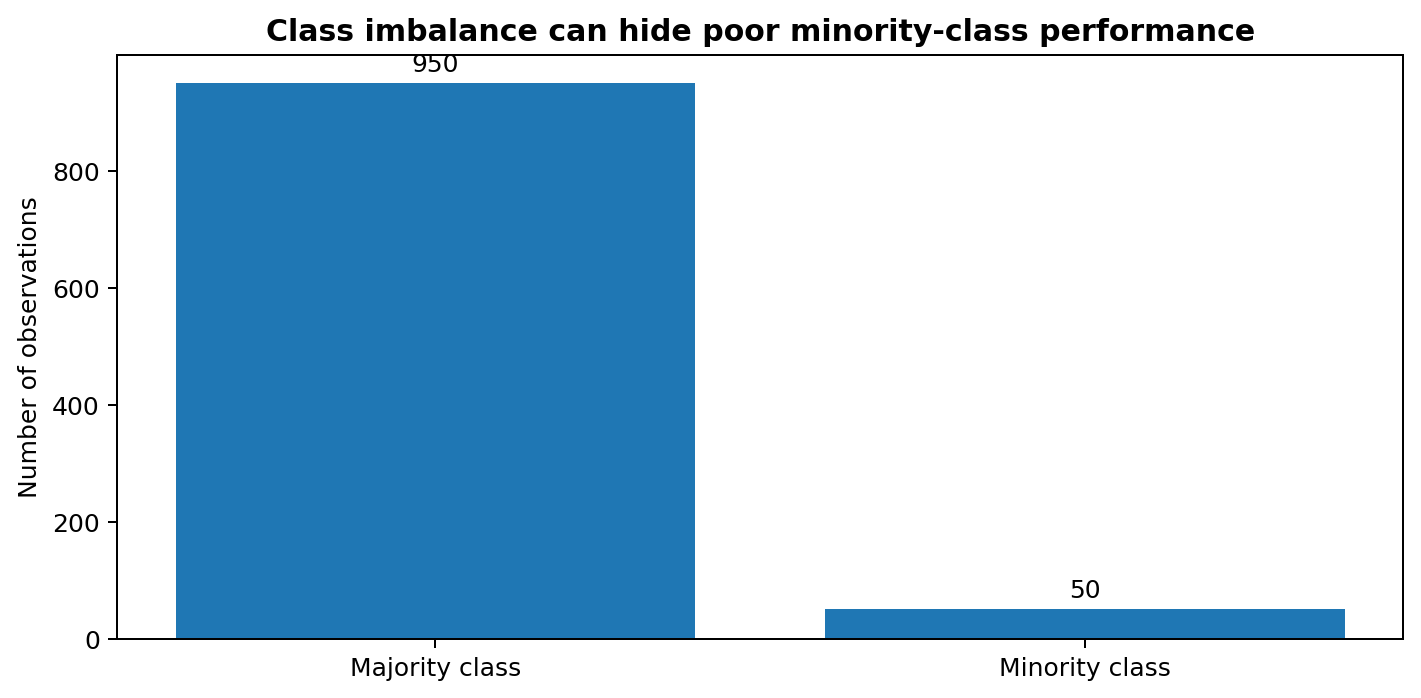
L'évaluation doit donc examiner le rappel de la classe minoritaire, la précision, le F1-score, la matrice de confusion et le coût réel des faux positifs et faux négatifs.
1.23Baselines et Discipline Expérimentale
Une baseline est un résultat de référence simple utilisé pour juger si un système d'apprentissage plus sophistiqué apporte réellement de la valeur. Sans baseline, un score apparemment fort peut être difficile à interpréter.
- Définir une référence simple avant un ajustement intensif.
- Changer un nombre limité de facteurs à la fois.
- Conserver le même protocole de validation lors de la comparaison des expériences.
- Enregistrer les métriques, les hyperparamètres, la version du jeu de données et la version du prétraitement.
- Préférer les améliorations qui restent stables sur plusieurs validations.
1.24Surveillance et Dérive des Données
Le déploiement transforme le problème d'une expérience statique en un système vivant. Les distributions d'entrée, le comportement des utilisateurs, les règles métier, les capteurs et les conditions externes peuvent changer. La surveillance est utilisée pour détecter quand les données de production ne ressemblent plus à l'environnement d'entraînement.
- Surveiller les distributions d'entrée et les taux de valeurs manquantes.
- Suivre la qualité des prédictions quand les étiquettes de vérité terrain deviennent disponibles.
- Observer les sous-groupes importants séparément plutôt que seulement les moyennes globales.
- Définir des seuils pour l'investigation, le rollback ou le réentraînement.
- Revalider un système réentraîné avant de remplacer la version déployée.
1.25Liste de Vérification Finale
Avant de passer aux algorithmes individuels, vérifiez que vous pouvez répondre avec confiance à chaque point ci-dessous :
- Je peux distinguer les observations, les caractéristiques, les cibles, les paramètres et les hyperparamètres.
- Je comprends l'apprentissage supervisé, non supervisé et par renforcement à un niveau conceptuel.
- Je sais pourquoi les données d'entraînement, de validation et de test ont des rôles différents.
- Je comprends la perte, l'optimisation, la généralisation, le sous-apprentissage et le sur-apprentissage.
- Je peux expliquer le biais et la variance conceptuellement.
- Je sais pourquoi les métriques d'évaluation doivent refléter le coût réel des erreurs.
- Je comprends la fuite de données et comment les pipelines de prétraitement la préviennent.
- Je sais pourquoi le déséquilibre des classes change la façon dont les performances doivent être évaluées.
- Je comprends la reproductibilité, les baselines, la surveillance et la dérive.