
1Introduction : le « mur du contexte »
Idée à retenir
Comprendre pourquoi une grande fenêtre de contexte ne remplace pas une vraie mémoire.
Explication pas à pas
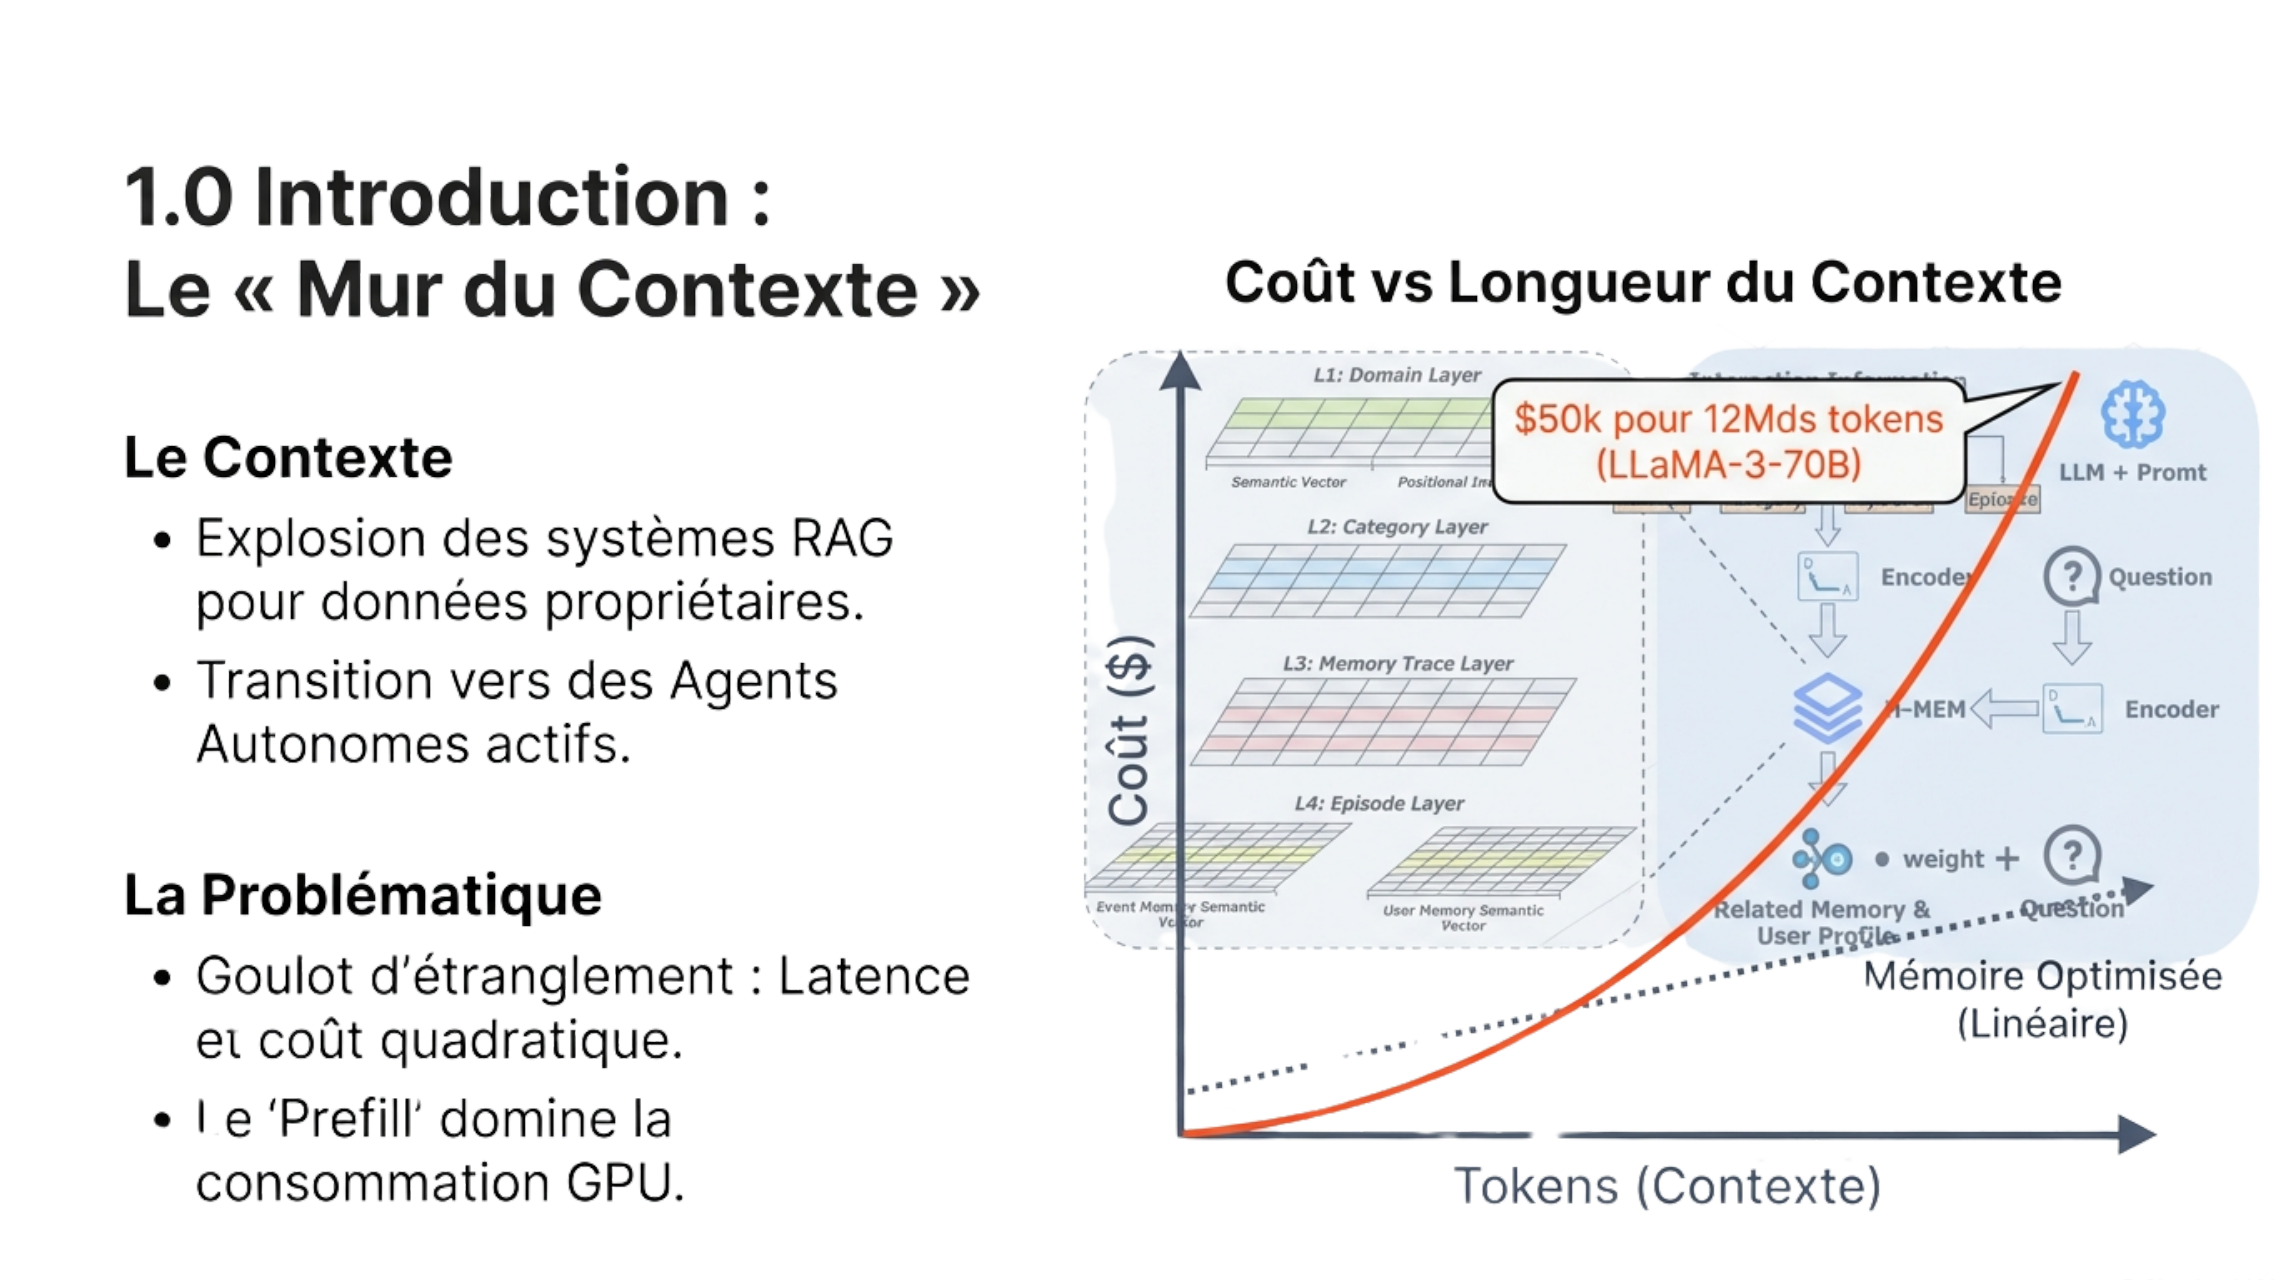
- Un LLM reçoit des jetons (tokens) dans une fenêtre de contexte limitée.
- Ajouter toujours plus d'historique augmente la quantité d'information à traiter.
- Une architecture mémoire garde seulement l'information utile dans le contexte actif et stocke le reste ailleurs.
Exemple simple
Imaginez un bureau : la fenêtre de contexte est la surface du bureau. Vous pouvez y poser quelques documents utiles, mais pas toute l'archive de l'entreprise. La mémoire externe, c'est l'armoire à côté.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Fenêtre de contexte | Informations visibles immédiatement par le modèle | Rapide, mais limitée |
| Mémoire externe | Informations stockées hors du prompt | Persistante et récupérable |
| Retrieval / récupération | Recherche de l'information utile | Évite de charger tout l'historique |
Schéma simplifié
Question utilisateur → sélectionner l'information pertinente → injecter un contexte compact → générer la réponse
2Objectifs et taxonomie de la mémoire
Idée à retenir
Identifier les grandes familles de mémoire avant de choisir une architecture.
Explication pas à pas
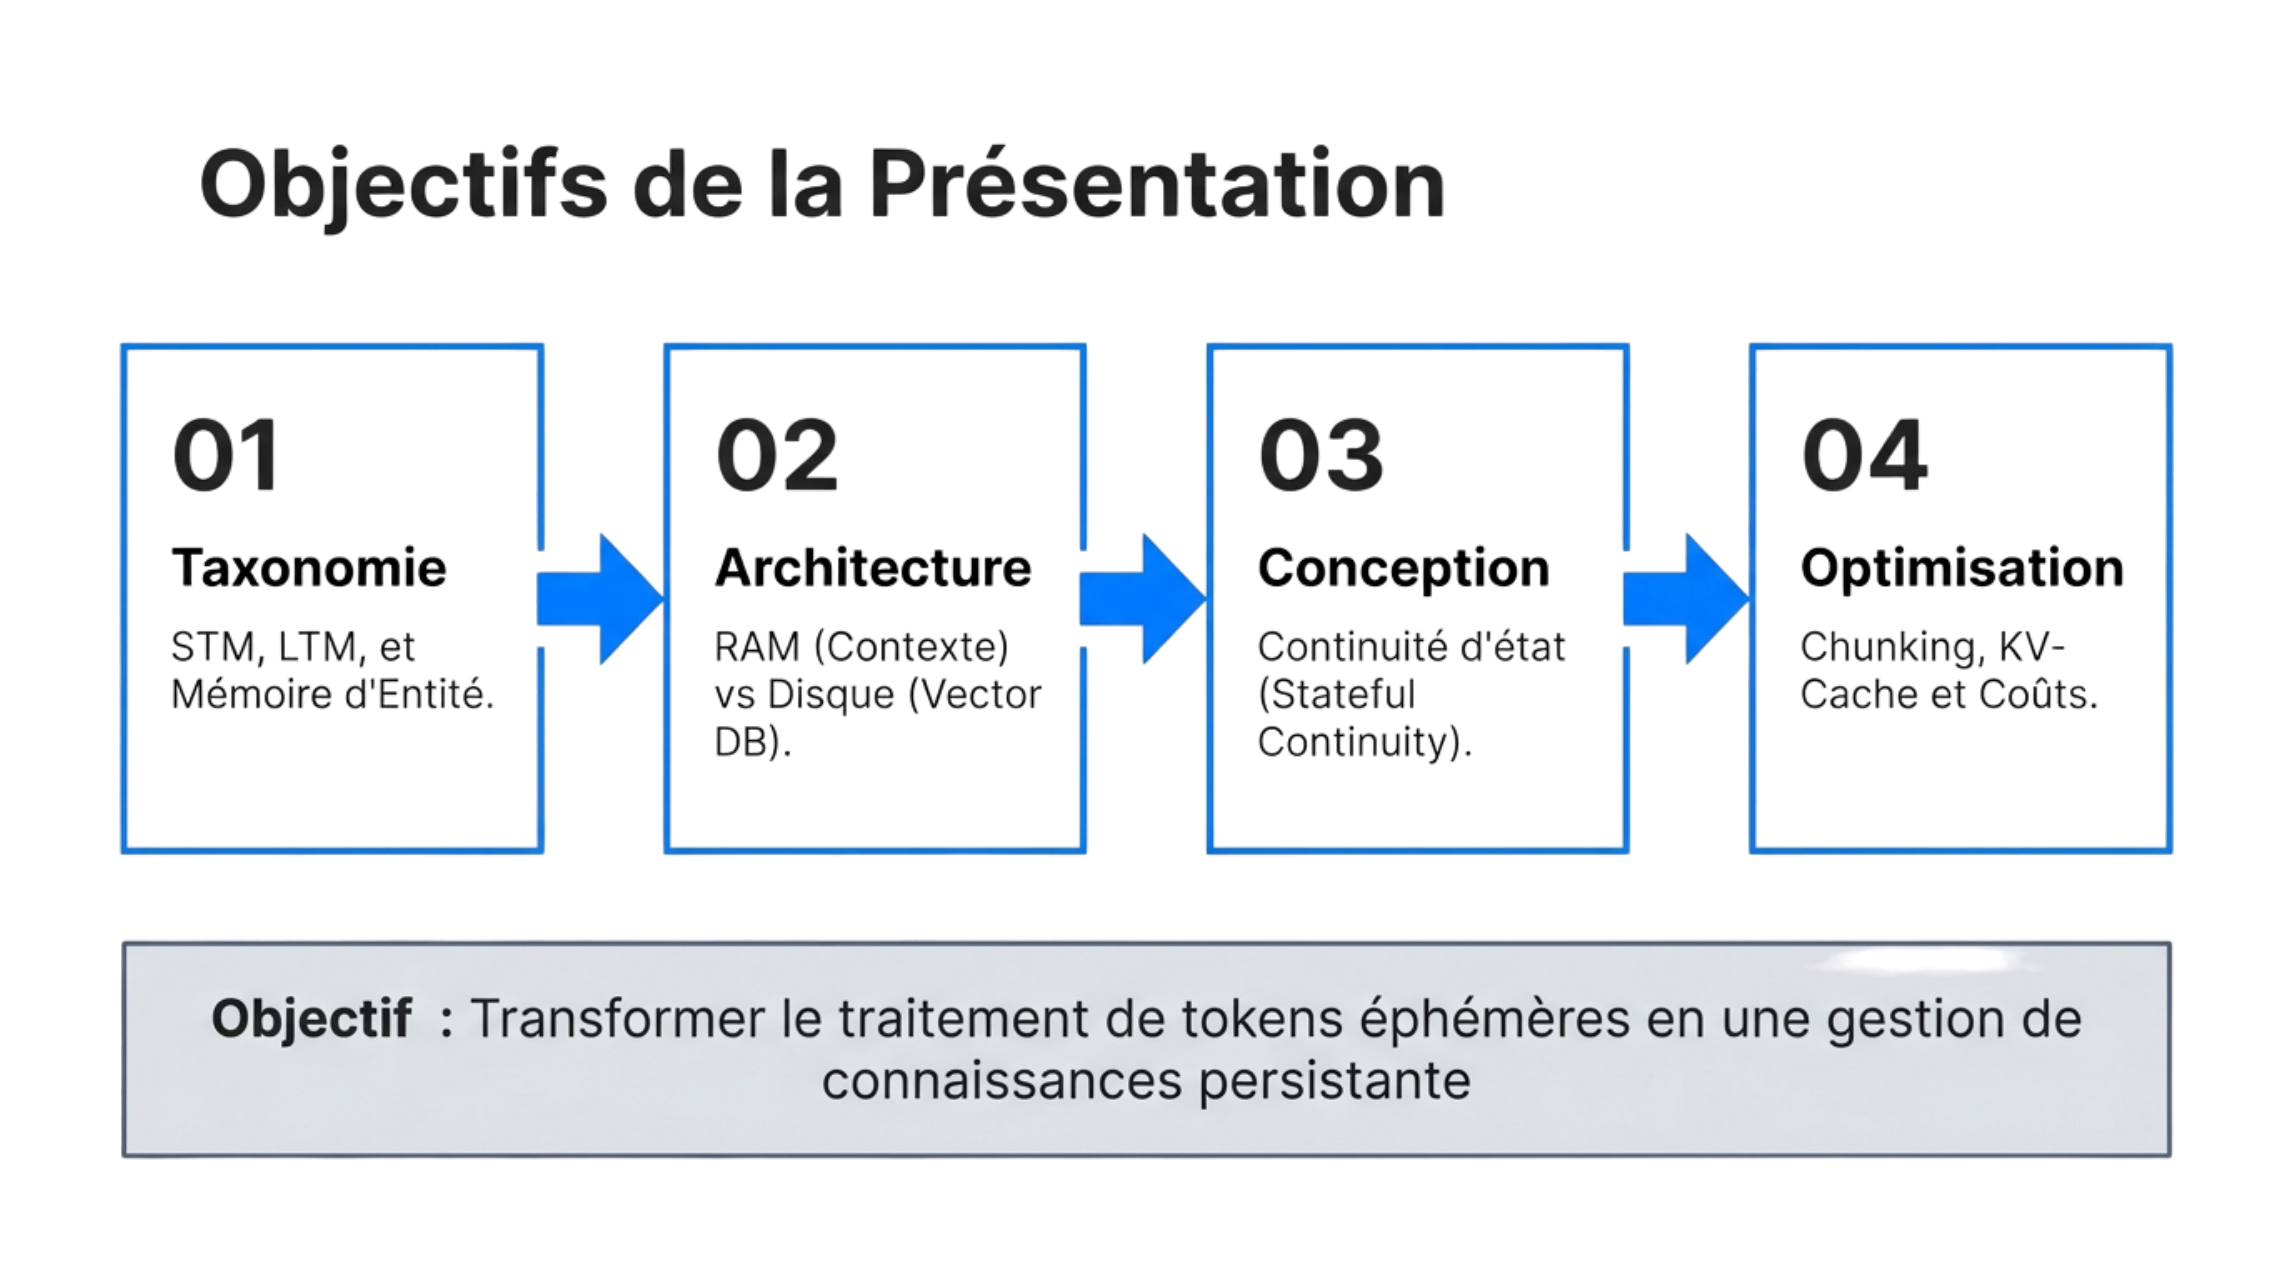
- La mémoire à court terme sert au travail immédiat.
- La mémoire à long terme conserve des informations persistantes.
- La mémoire d'entité résume des faits importants sur une personne, un objet ou un sujet.
- L'optimisation concerne le découpage, la recherche, la compression et les coûts.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Court terme | Contexte récent | Conversation en cours |
| Long terme | Connaissance persistante | Documents, faits, événements |
| Entité / résumé | État compact | Préférences ou faits saillants |
| Optimisation | Accès efficace | Chunking, embeddings, cache |
Schéma simplifié
Information entrante → classifier le type de mémoire → stocker au bon endroit → récupérer au bon moment
3Mémoire à court terme (Working Memory)
Idée à retenir
Conserver temporairement ce qui est nécessaire pour comprendre l'échange actuel.
Explication pas à pas
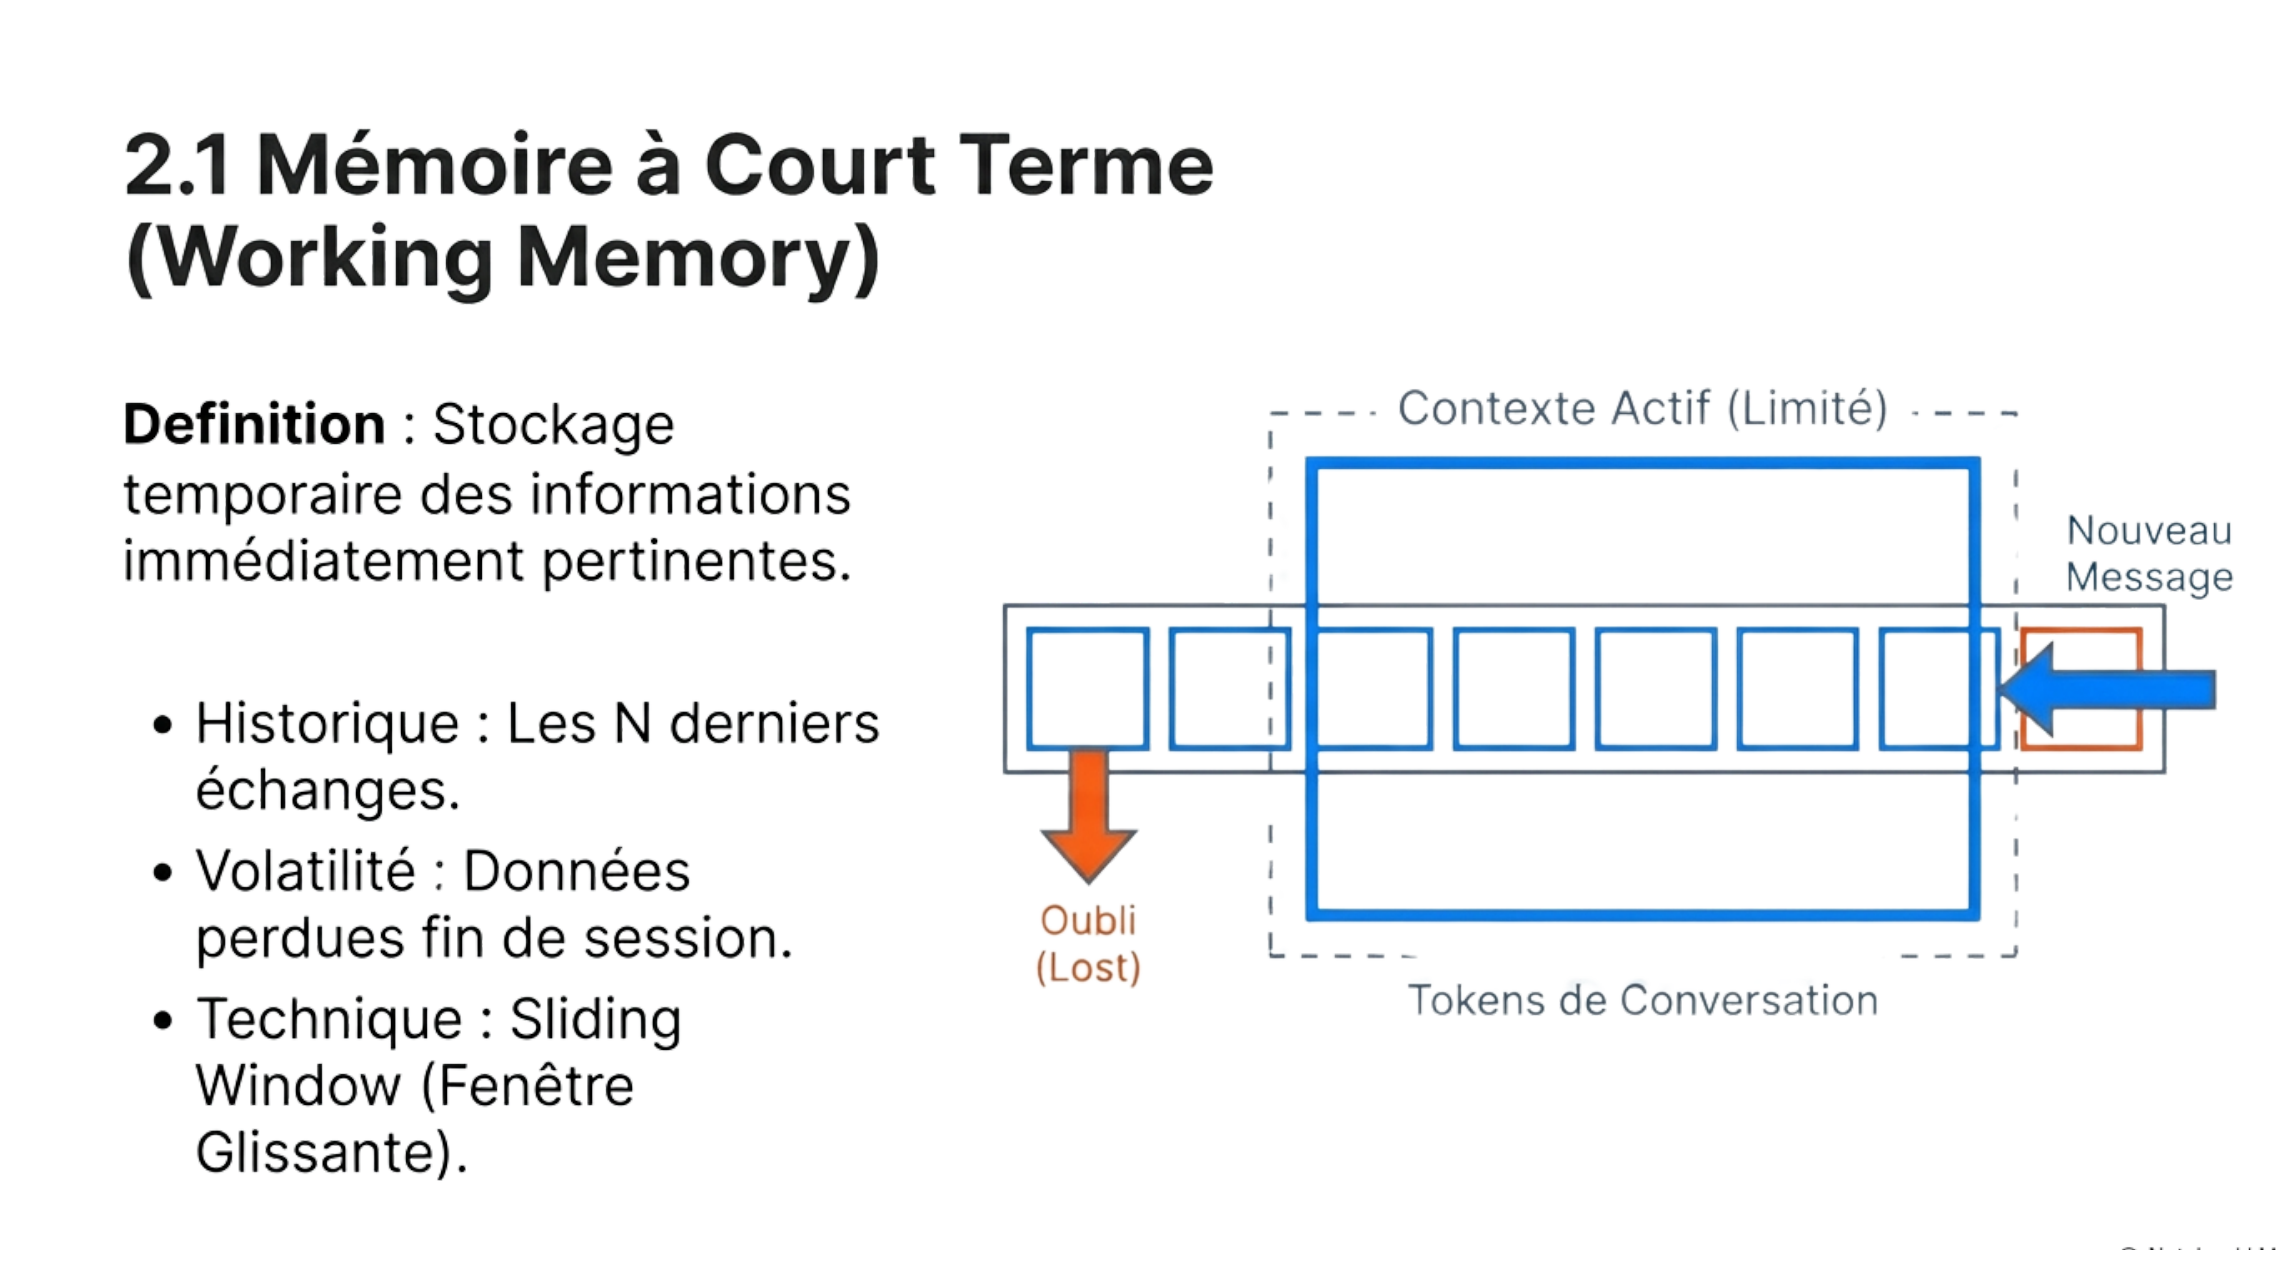
- Elle contient généralement les derniers messages ou éléments de tâche.
- Elle est volatile : sans sauvegarde, son contenu peut disparaître à la fin de la session.
- Une fenêtre glissante retire les éléments les plus anciens lorsque de nouveaux messages arrivent.
Exemple simple
Dans une conversation, si l'utilisateur dit « compare-le avec le deuxième modèle », le système doit encore savoir quels modèles viennent d'être mentionnés.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Avantage | Accès immédiat | Bonne continuité locale |
| Limite | Taille finie | Les anciens éléments sortent du contexte |
| Stratégie | Fenêtre glissante | Garder les N échanges les plus utiles |
Schéma simplifié
Nouveau message → ajouter au contexte → vérifier la limite → retirer ou résumer l'ancien contenu
4Mémoire à long terme (Long-Term Memory)
Idée à retenir
Conserver des connaissances au-delà d'une seule conversation.
Explication pas à pas
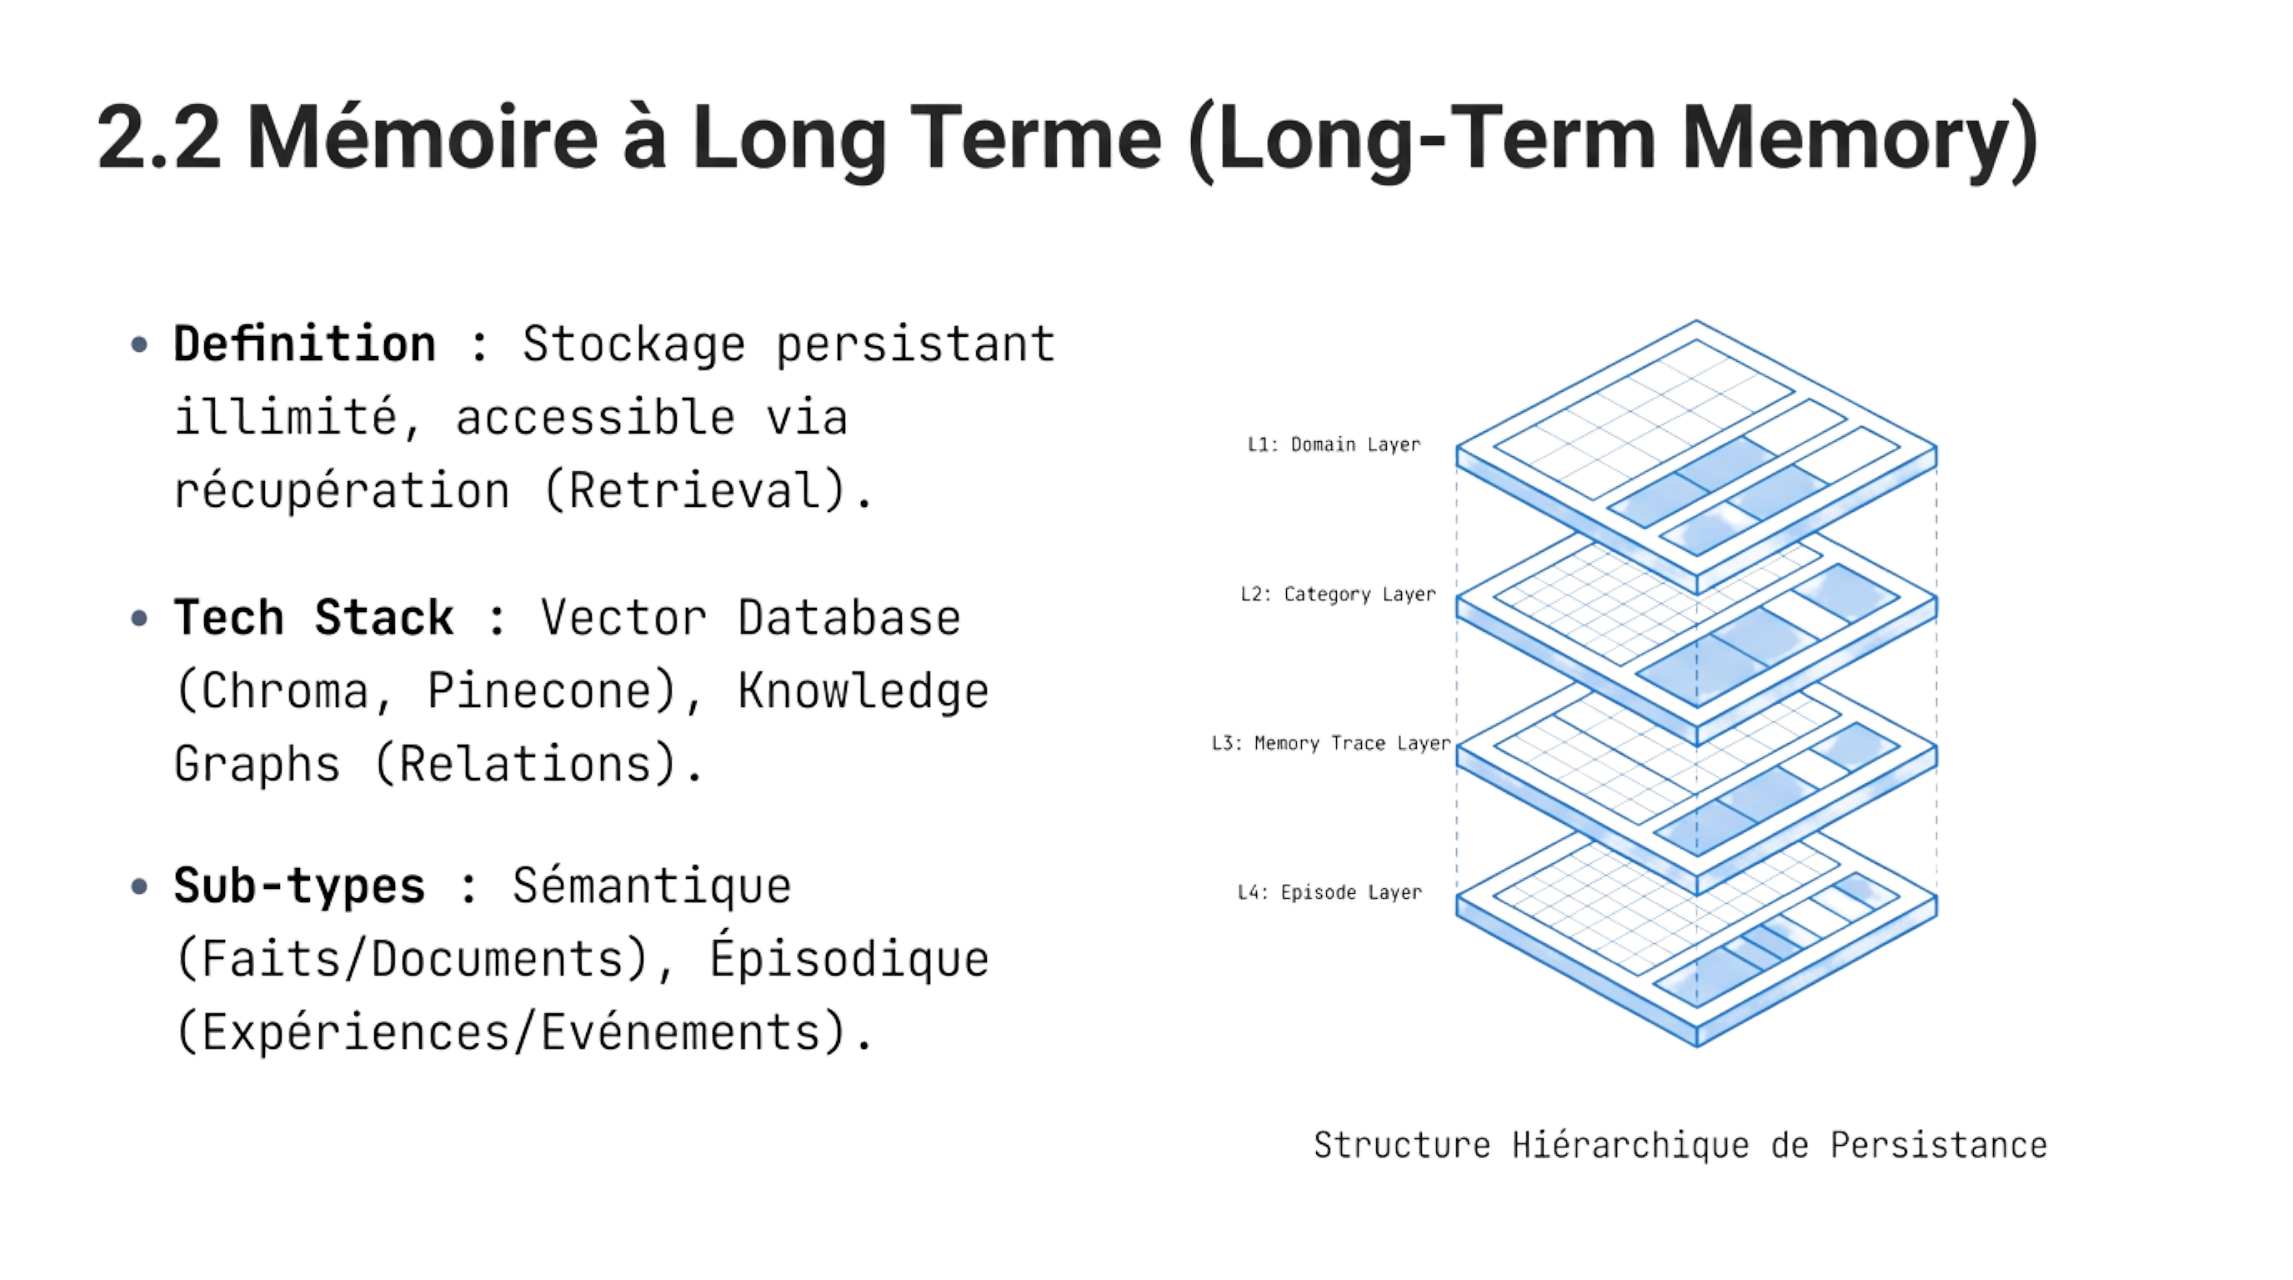
- Le stockage est séparé du contexte actif du LLM.
- Une base vectorielle peut retrouver des contenus proches par leur sens.
- Un graphe de connaissances peut représenter explicitement les relations entre entités.
- La mémoire sémantique stocke des faits/documents ; la mémoire épisodique stocke des événements ou expériences.
Exemple simple
Au lieu de mettre un manuel de 500 pages dans chaque prompt, le système l'archive et récupère uniquement les passages utiles à la question.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Mémoire sémantique | Faits et connaissances | Documentation produit |
| Mémoire épisodique | Événements et interactions | Résultat d'une tâche précédente |
| Base vectorielle | Recherche par similarité | Retrouver un passage proche du sens |
| Graphe | Relations explicites | Client → possède → produit |
Schéma simplifié
Question → créer une requête de recherche → récupérer quelques souvenirs pertinents → les ajouter au contexte
5Mémoire d'entité et résumés
Idée à retenir
Transformer un historique long en informations compactes et réutilisables.
Explication pas à pas
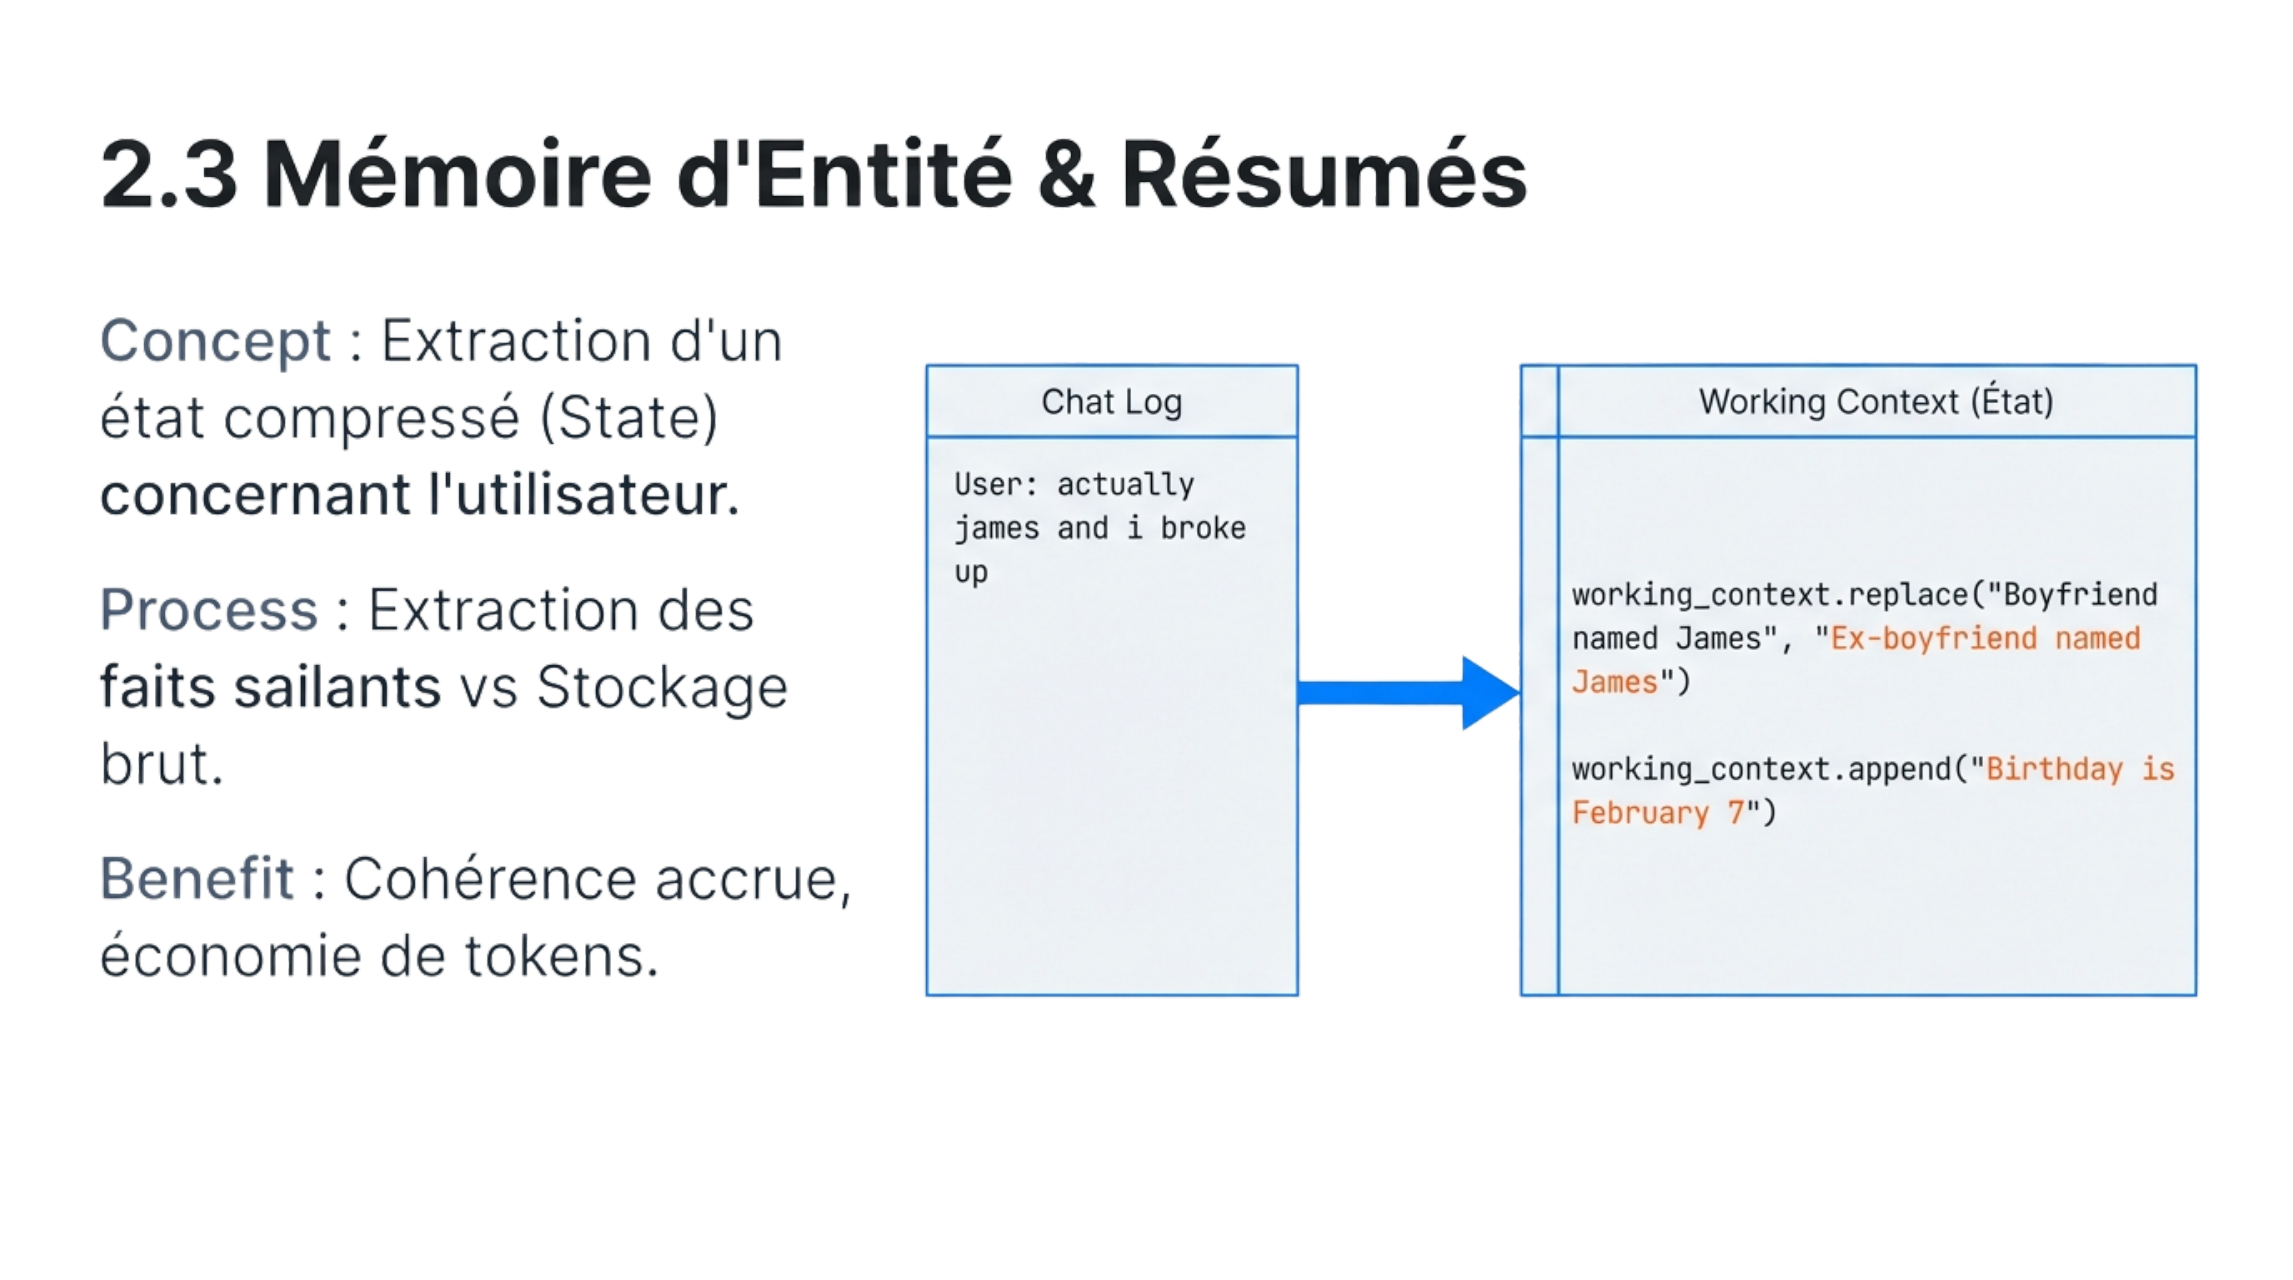
- Le système extrait les faits saillants au lieu de stocker uniquement du texte brut.
- Un résumé réduit le nombre de jetons nécessaires pour représenter un long historique.
- Les faits doivent pouvoir être mis à jour lorsqu'une nouvelle information remplace l'ancienne.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Texte brut | Très détaillé | Coûteux à relire |
| Résumé | Compact | Peut perdre certains détails |
| État structuré | Facile à mettre à jour | Nécessite une bonne extraction |
Schéma simplifié
Conversation brute → extraire les faits → fusionner avec l'état existant → sauvegarder un résumé compact
6Analogie OS : contexte, RAM et stockage
Idée à retenir
Utiliser une analogie informatique simple pour comprendre l'architecture mémoire.
Explication pas à pas
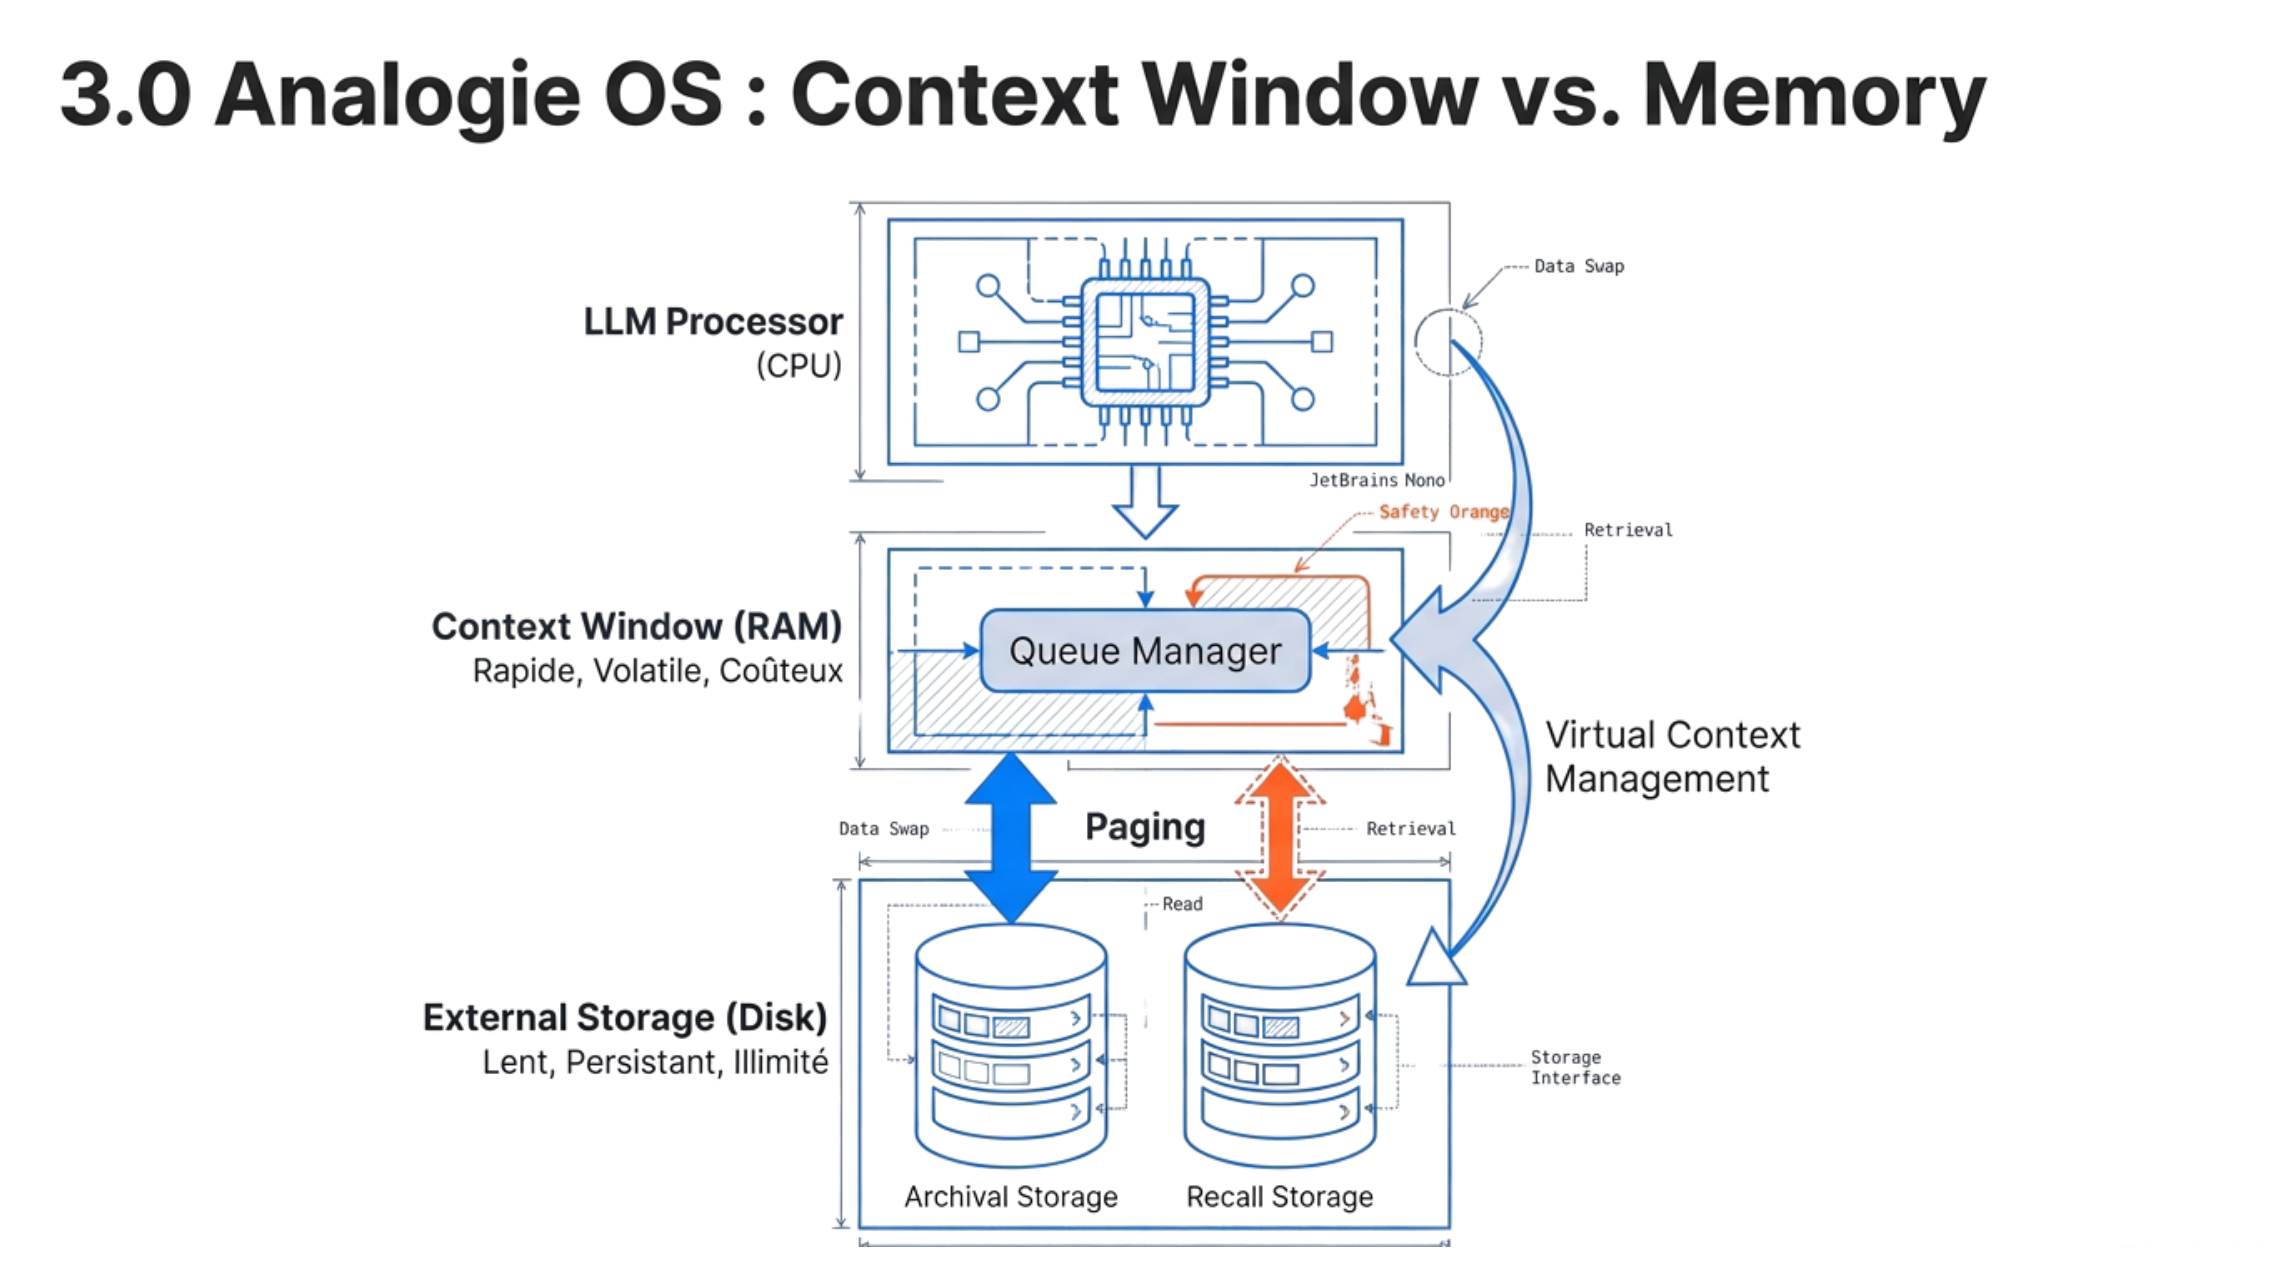
- Le LLM joue le rôle du processeur : il effectue le calcul.
- La fenêtre de contexte ressemble à la RAM : rapide mais limitée.
- La mémoire externe ressemble au disque : plus persistante, mais elle doit être consultée.
- Un gestionnaire choisit ce qui doit être chargé dans le contexte.
| Élément | Analogie OS | Rôle |
|---|---|---|
| LLM | CPU / processeur | Traite l'information |
| Contexte | RAM | Travail immédiat |
| Vector DB / stockage | Disque | Persistance |
| Retrieval | Chargement / paging | Ramène les données utiles |
Schéma simplifié
Stockage externe ⇄ récupération ⇄ contexte actif → LLM → résultat
7Mémoire vs prompt
Idée à retenir
Ne pas confondre les règles du système avec les données qui évoluent.
Explication pas à pas
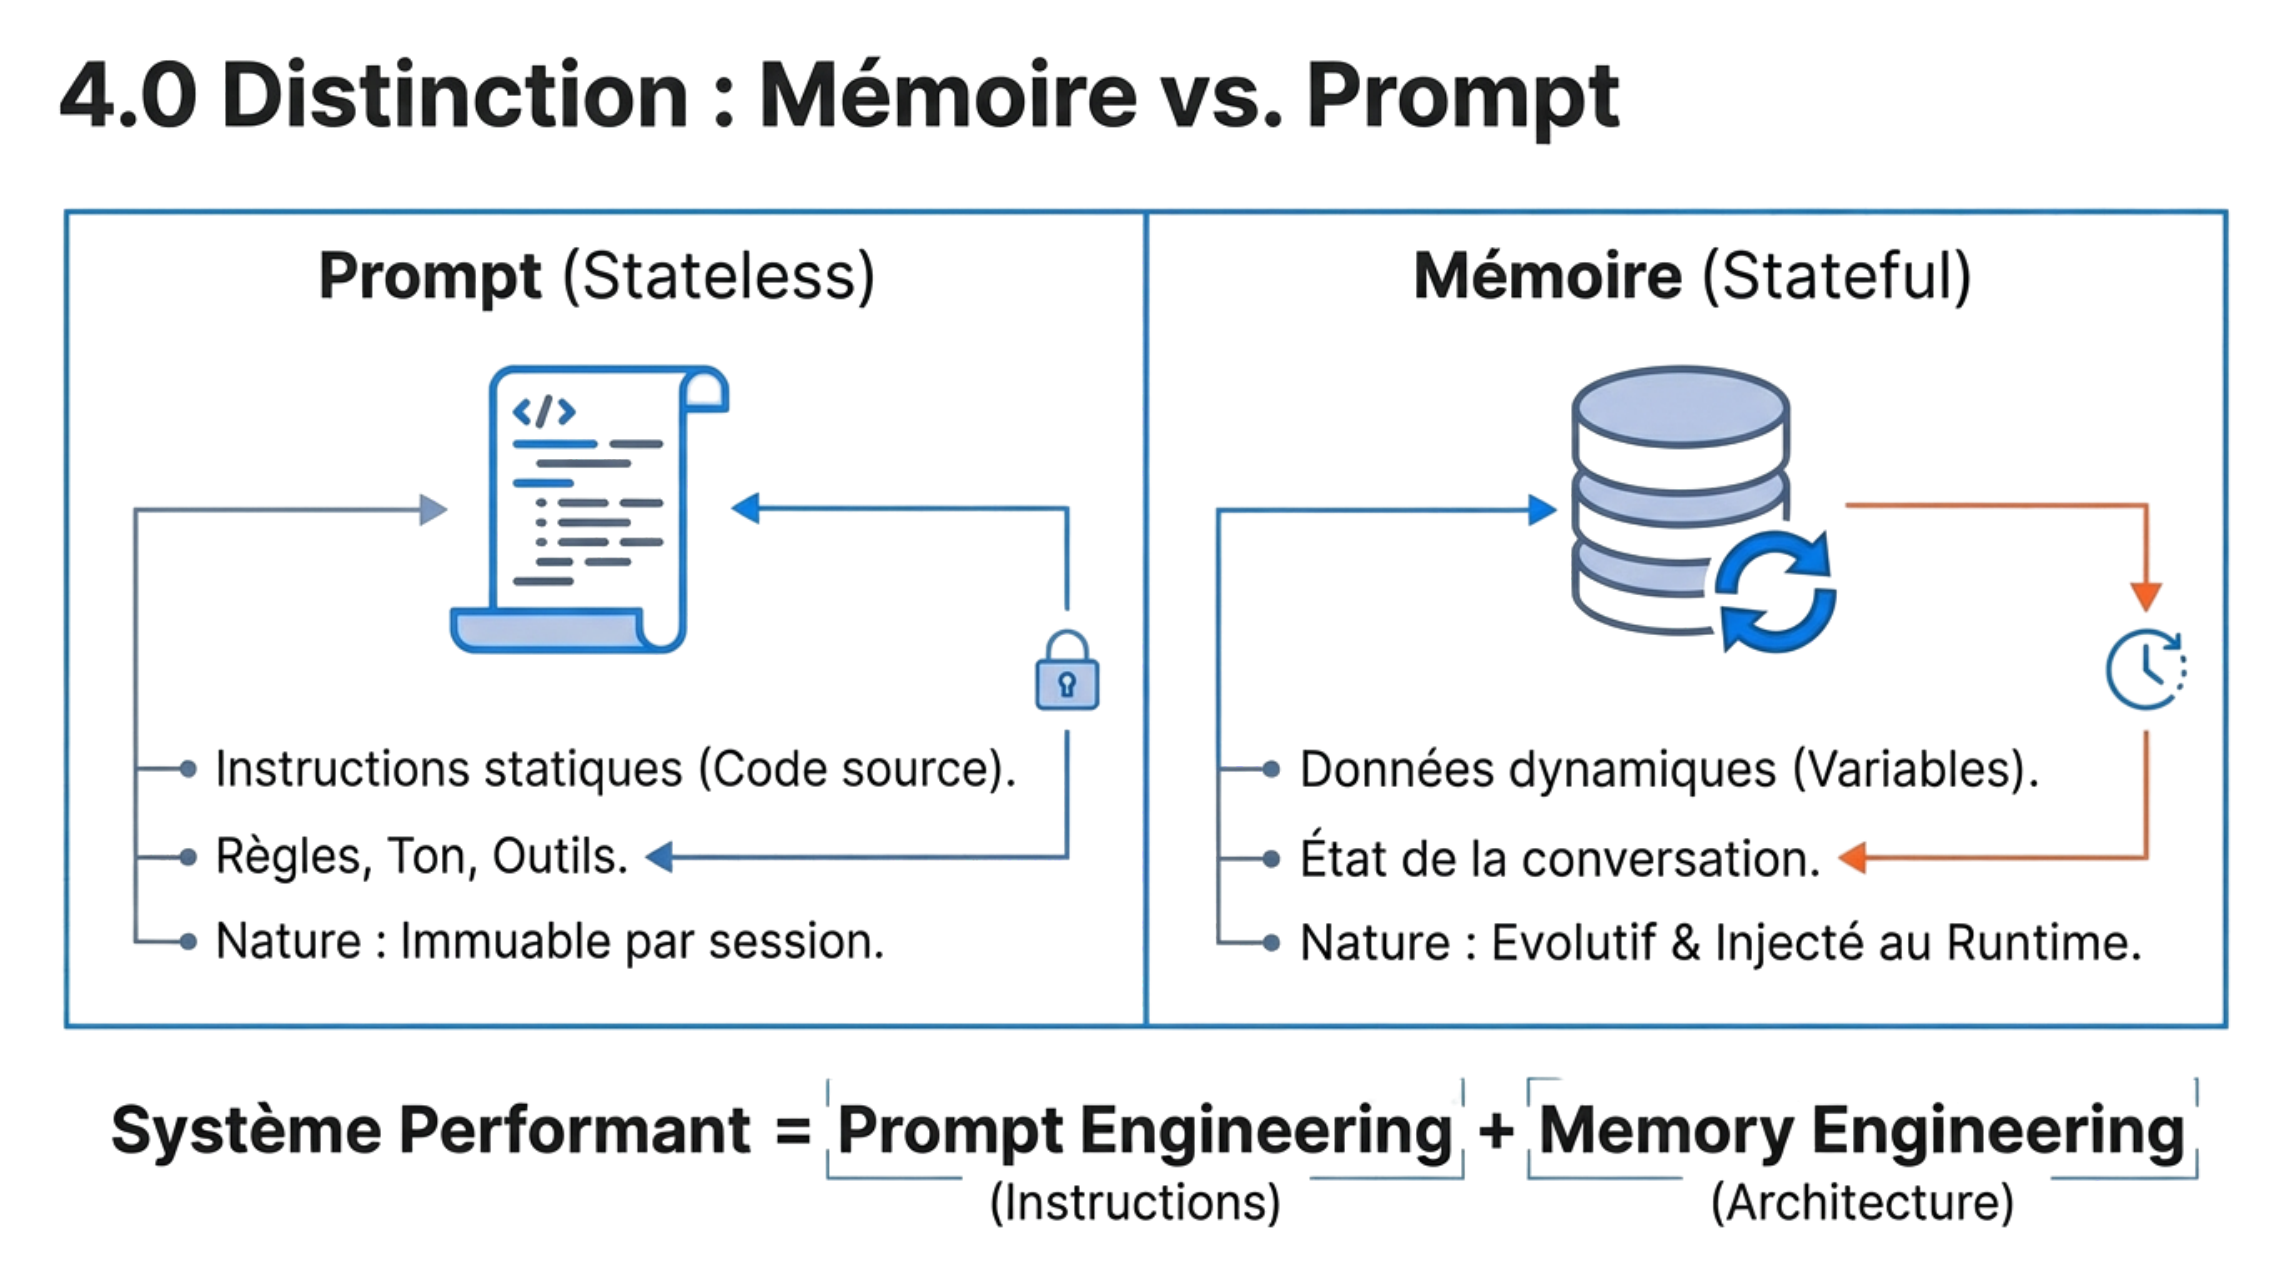
- Le prompt système décrit généralement les règles, le rôle, le ton et les outils.
- La mémoire contient un état dynamique : historique utile, faits, résultats ou progression.
- Le prompt répond à « comment agir ? » ; la mémoire répond à « que faut-il savoir maintenant ? ».
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Prompt | Instructions relativement stables | Rôle, règles, format |
| Mémoire | Données dynamiques | État, faits, historique |
| Ensemble | Comportement + contexte | Système cohérent |
Schéma simplifié
Prompt système + mémoire récupérée + question actuelle → contexte final envoyé au LLM
8Gestion de mémoire dans un système RAG
Idée à retenir
Comprendre le chemin complet entre la question et la génération.
Explication pas à pas
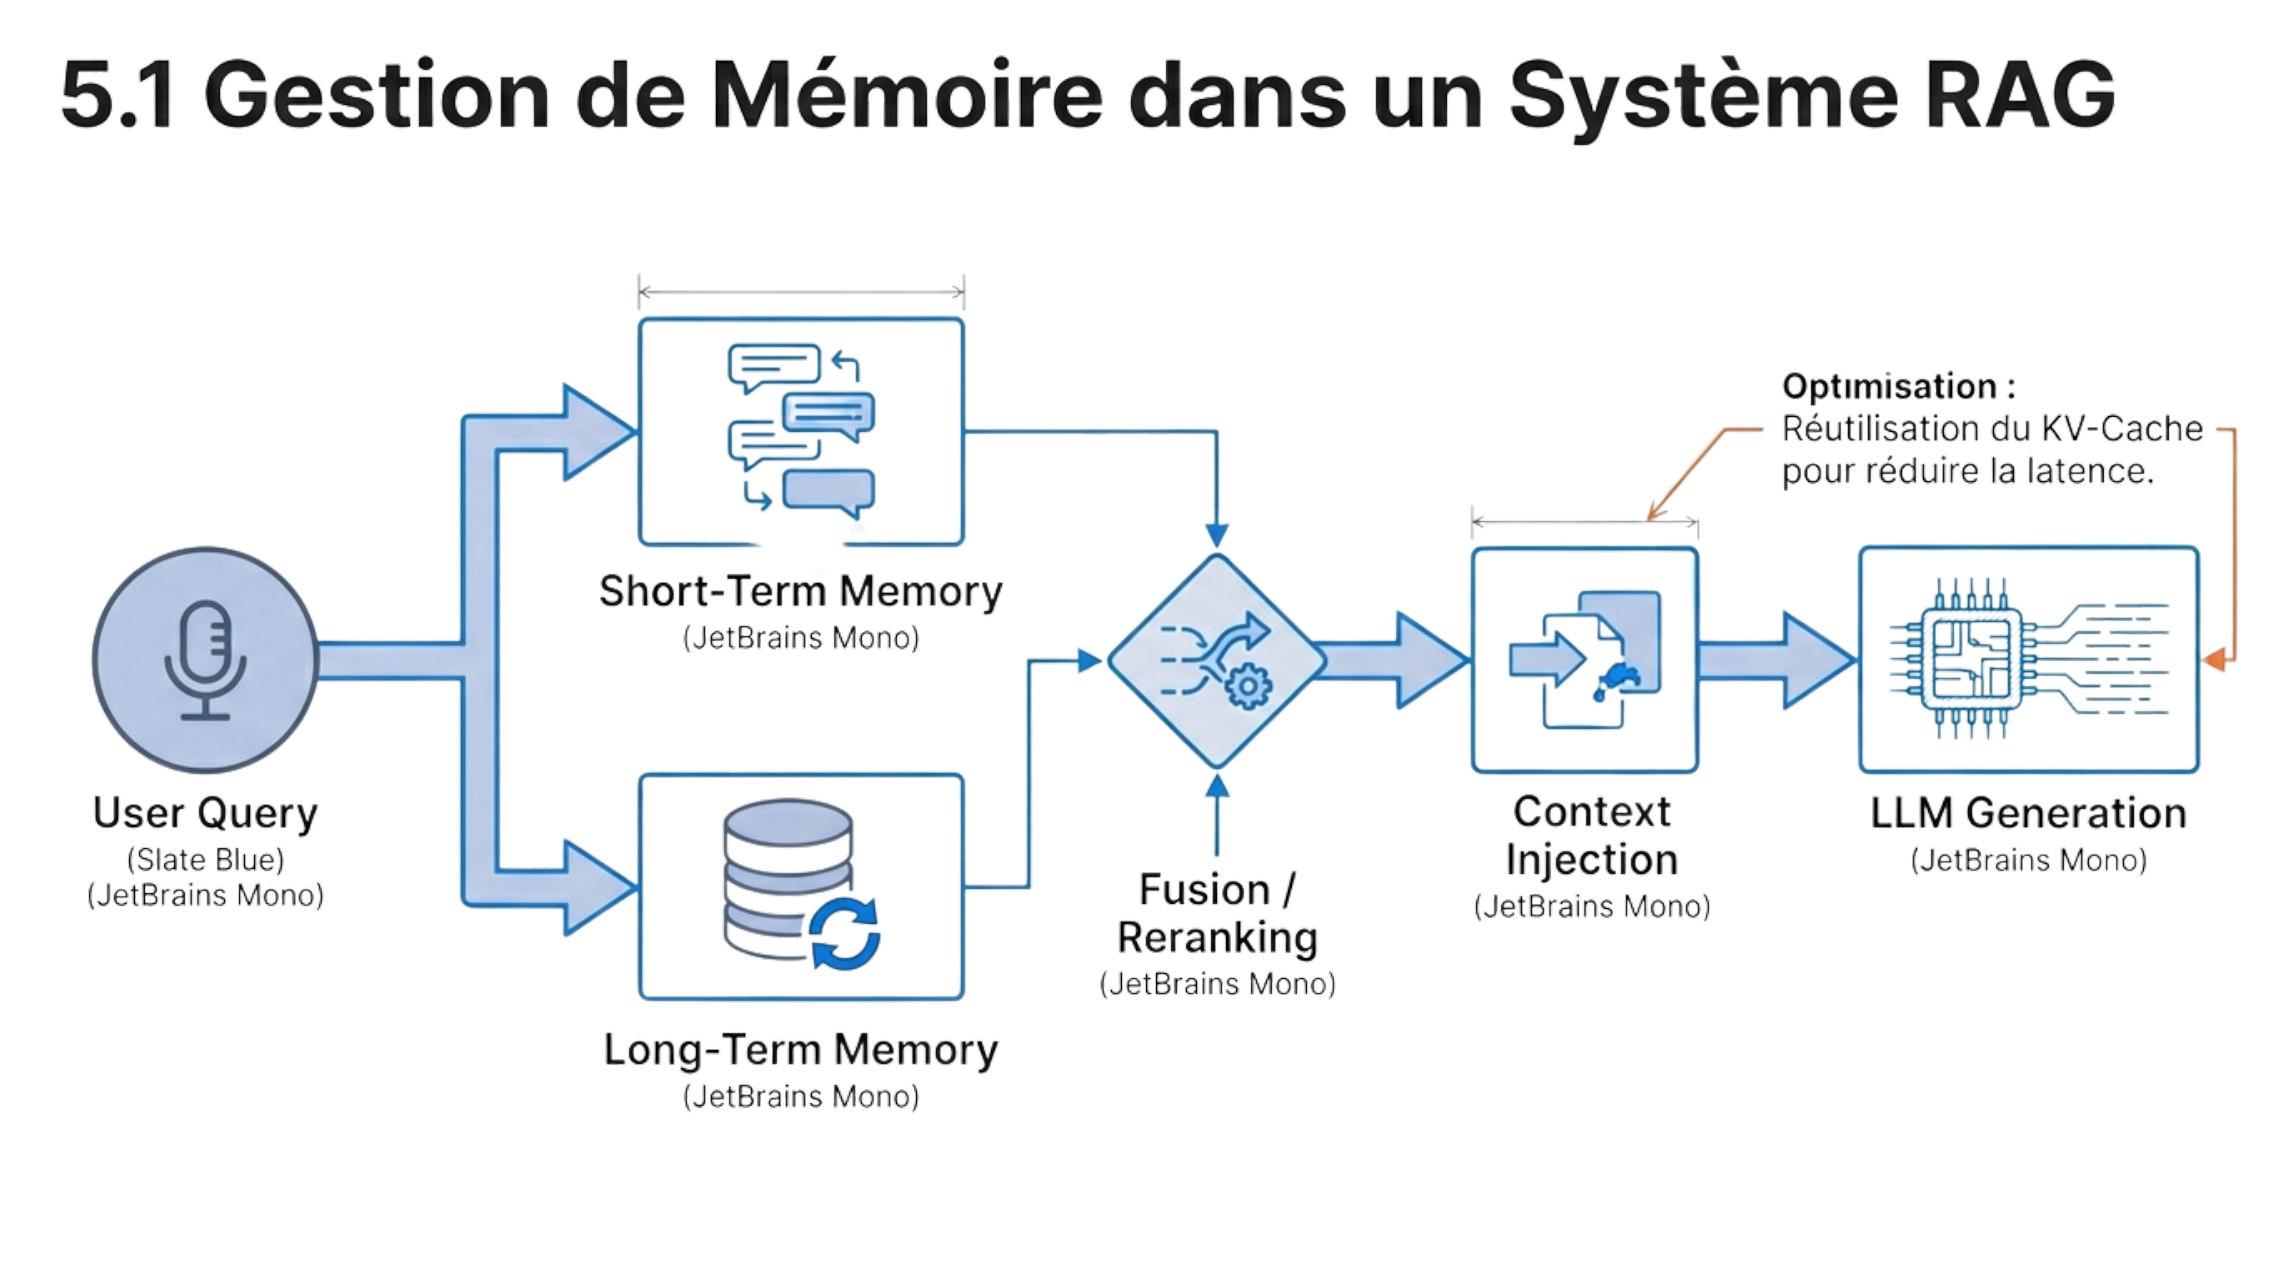
- RAG signifie Retrieval-Augmented Generation : la génération est enrichie par des informations récupérées.
- La requête peut utiliser la mémoire récente et une base documentaire persistante.
- La fusion/reranking classe les résultats afin de ne garder que les plus utiles.
- Le contexte sélectionné est injecté avant la génération de la réponse.
| Étape | Rôle / signification | Exemple ou remarque |
|---|---|---|
| 1. Requête | Comprendre le besoin | Question utilisateur |
| 2. Retrieval | Chercher des candidats | Vector DB / recherche |
| 3. Reranking | Classer les candidats | Garder les meilleurs |
| 4. Injection | Construire le contexte | Passages + question |
| 5. Génération | Produire la réponse | LLM |
Schéma simplifié
Utilisateur → recherche court terme + long terme → fusion/reranking → injection du contexte → LLM → réponse
9Gestion de mémoire dans les agents IA
Idée à retenir
Comprendre pourquoi un agent doit aussi écrire et maintenir sa mémoire.
Explication pas à pas
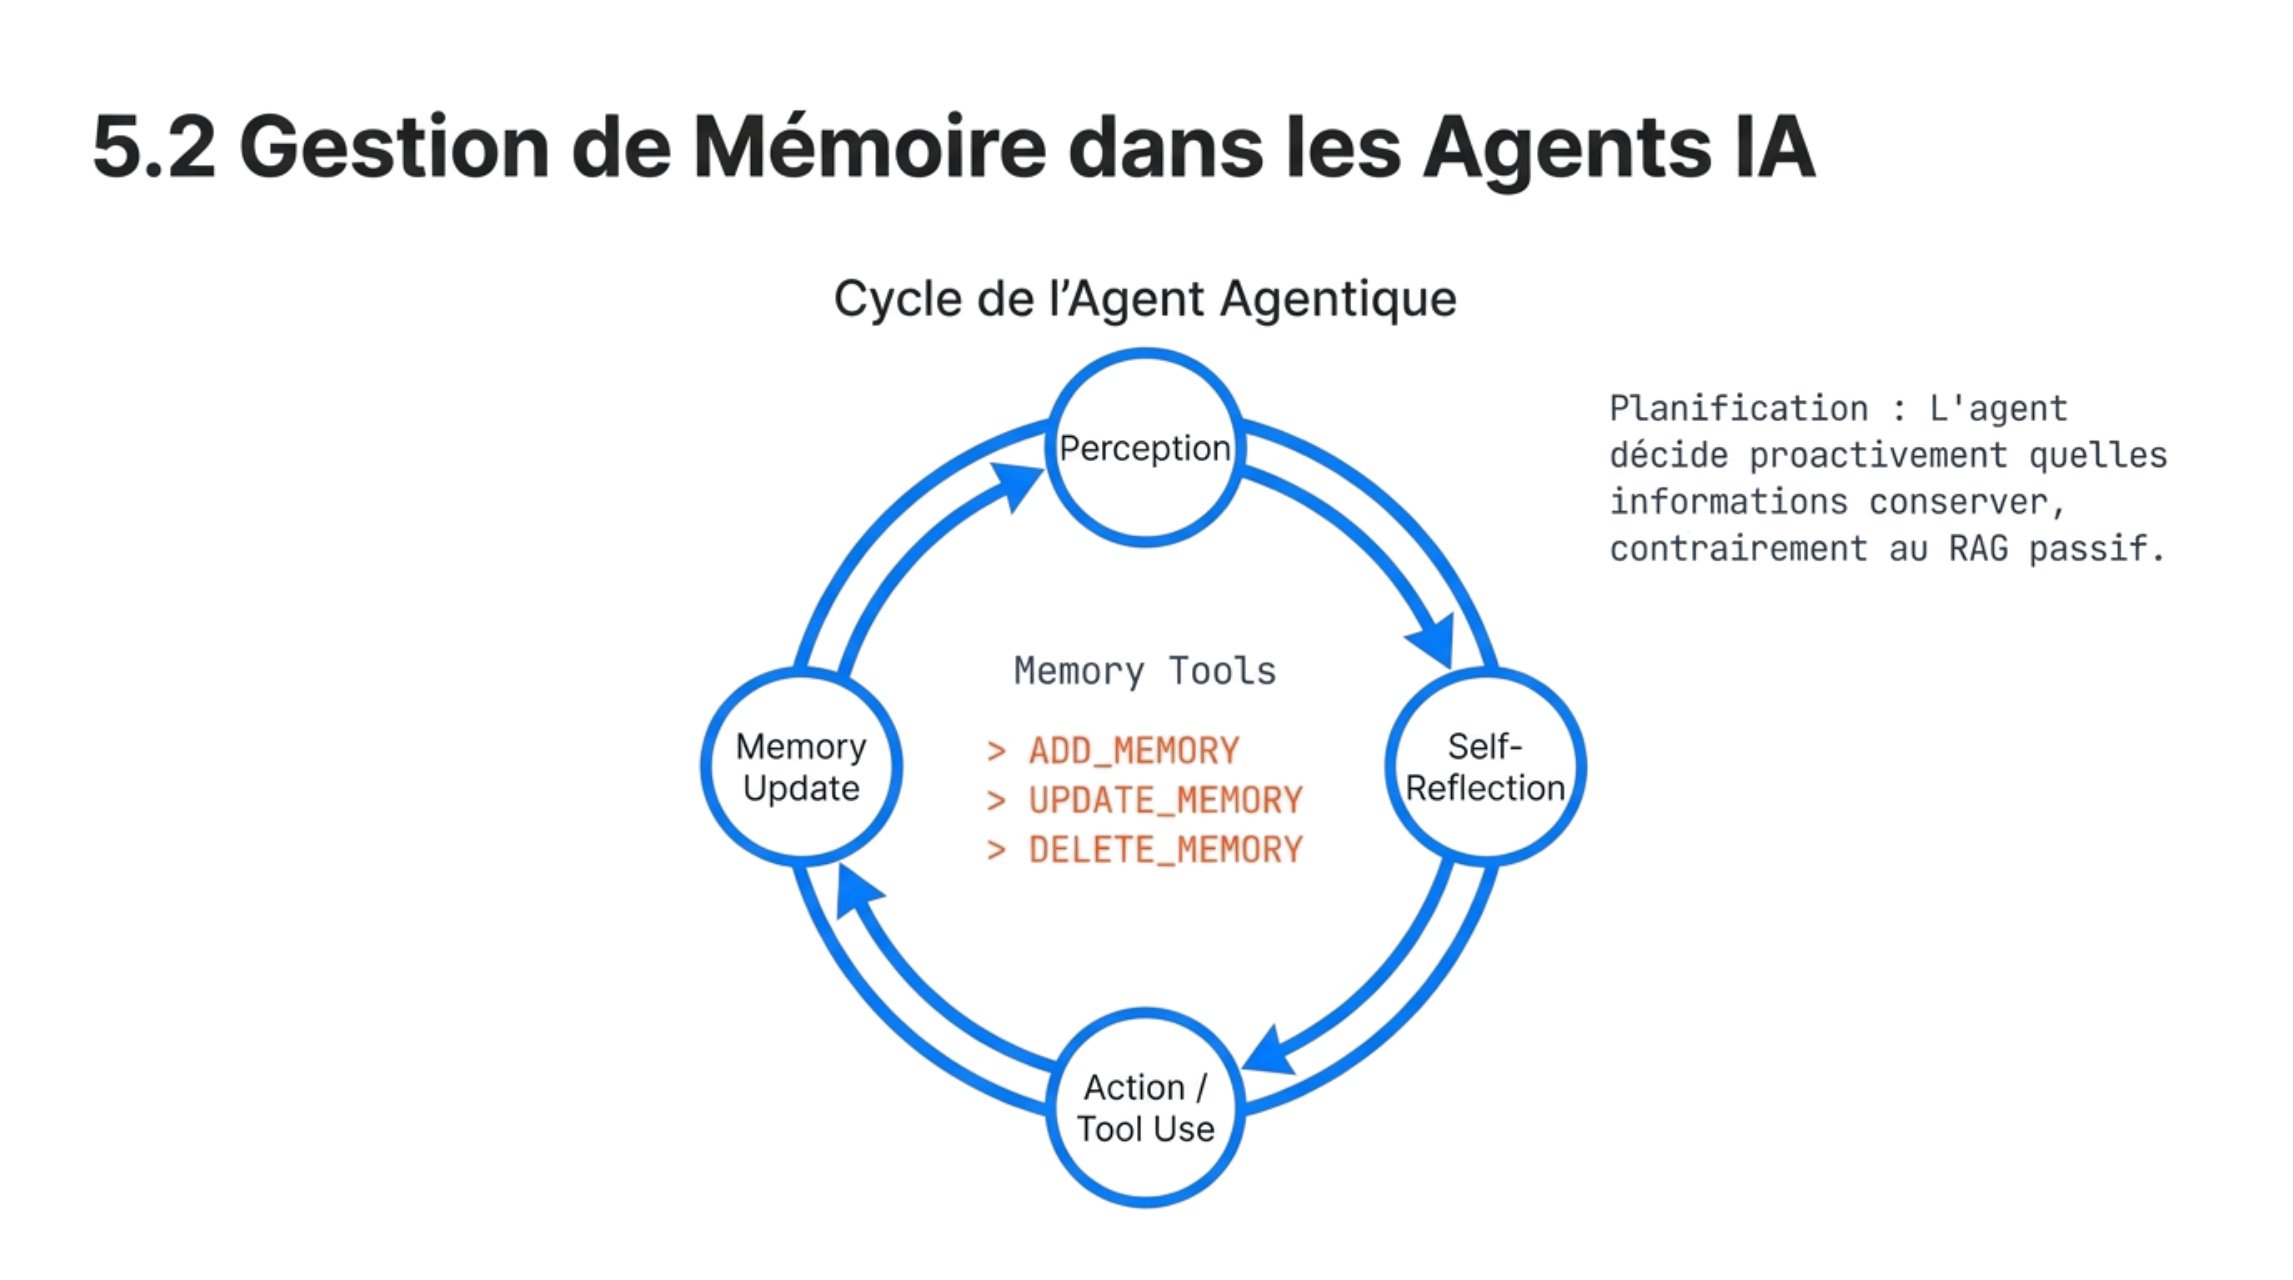
- Un agent observe, réfléchit, agit et peut ensuite mettre à jour sa mémoire.
ADD_MEMORYajoute un nouveau souvenir ;UPDATE_MEMORYcorrige ou enrichit ;DELETE_MEMORYsupprime l'obsolète.- Le défi n'est pas seulement de stocker, mais de décider ce qui mérite d'être conservé.
| Opération | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Ajouter | Nouvelle information durable | Résultat confirmé |
| Mettre à jour | Information modifiée | Nouveau statut |
| Supprimer | Information obsolète | Ancienne hypothèse |
| Réfléchir | Décider quoi mémoriser | Filtrer le bruit |
Schéma simplifié
Perception → réflexion → action/outils → résultat → décision mémoire → nouvelle perception
10Chunking et embeddings
Idée à retenir
Préparer les documents pour qu'ils soient retrouvés correctement.
Explication pas à pas
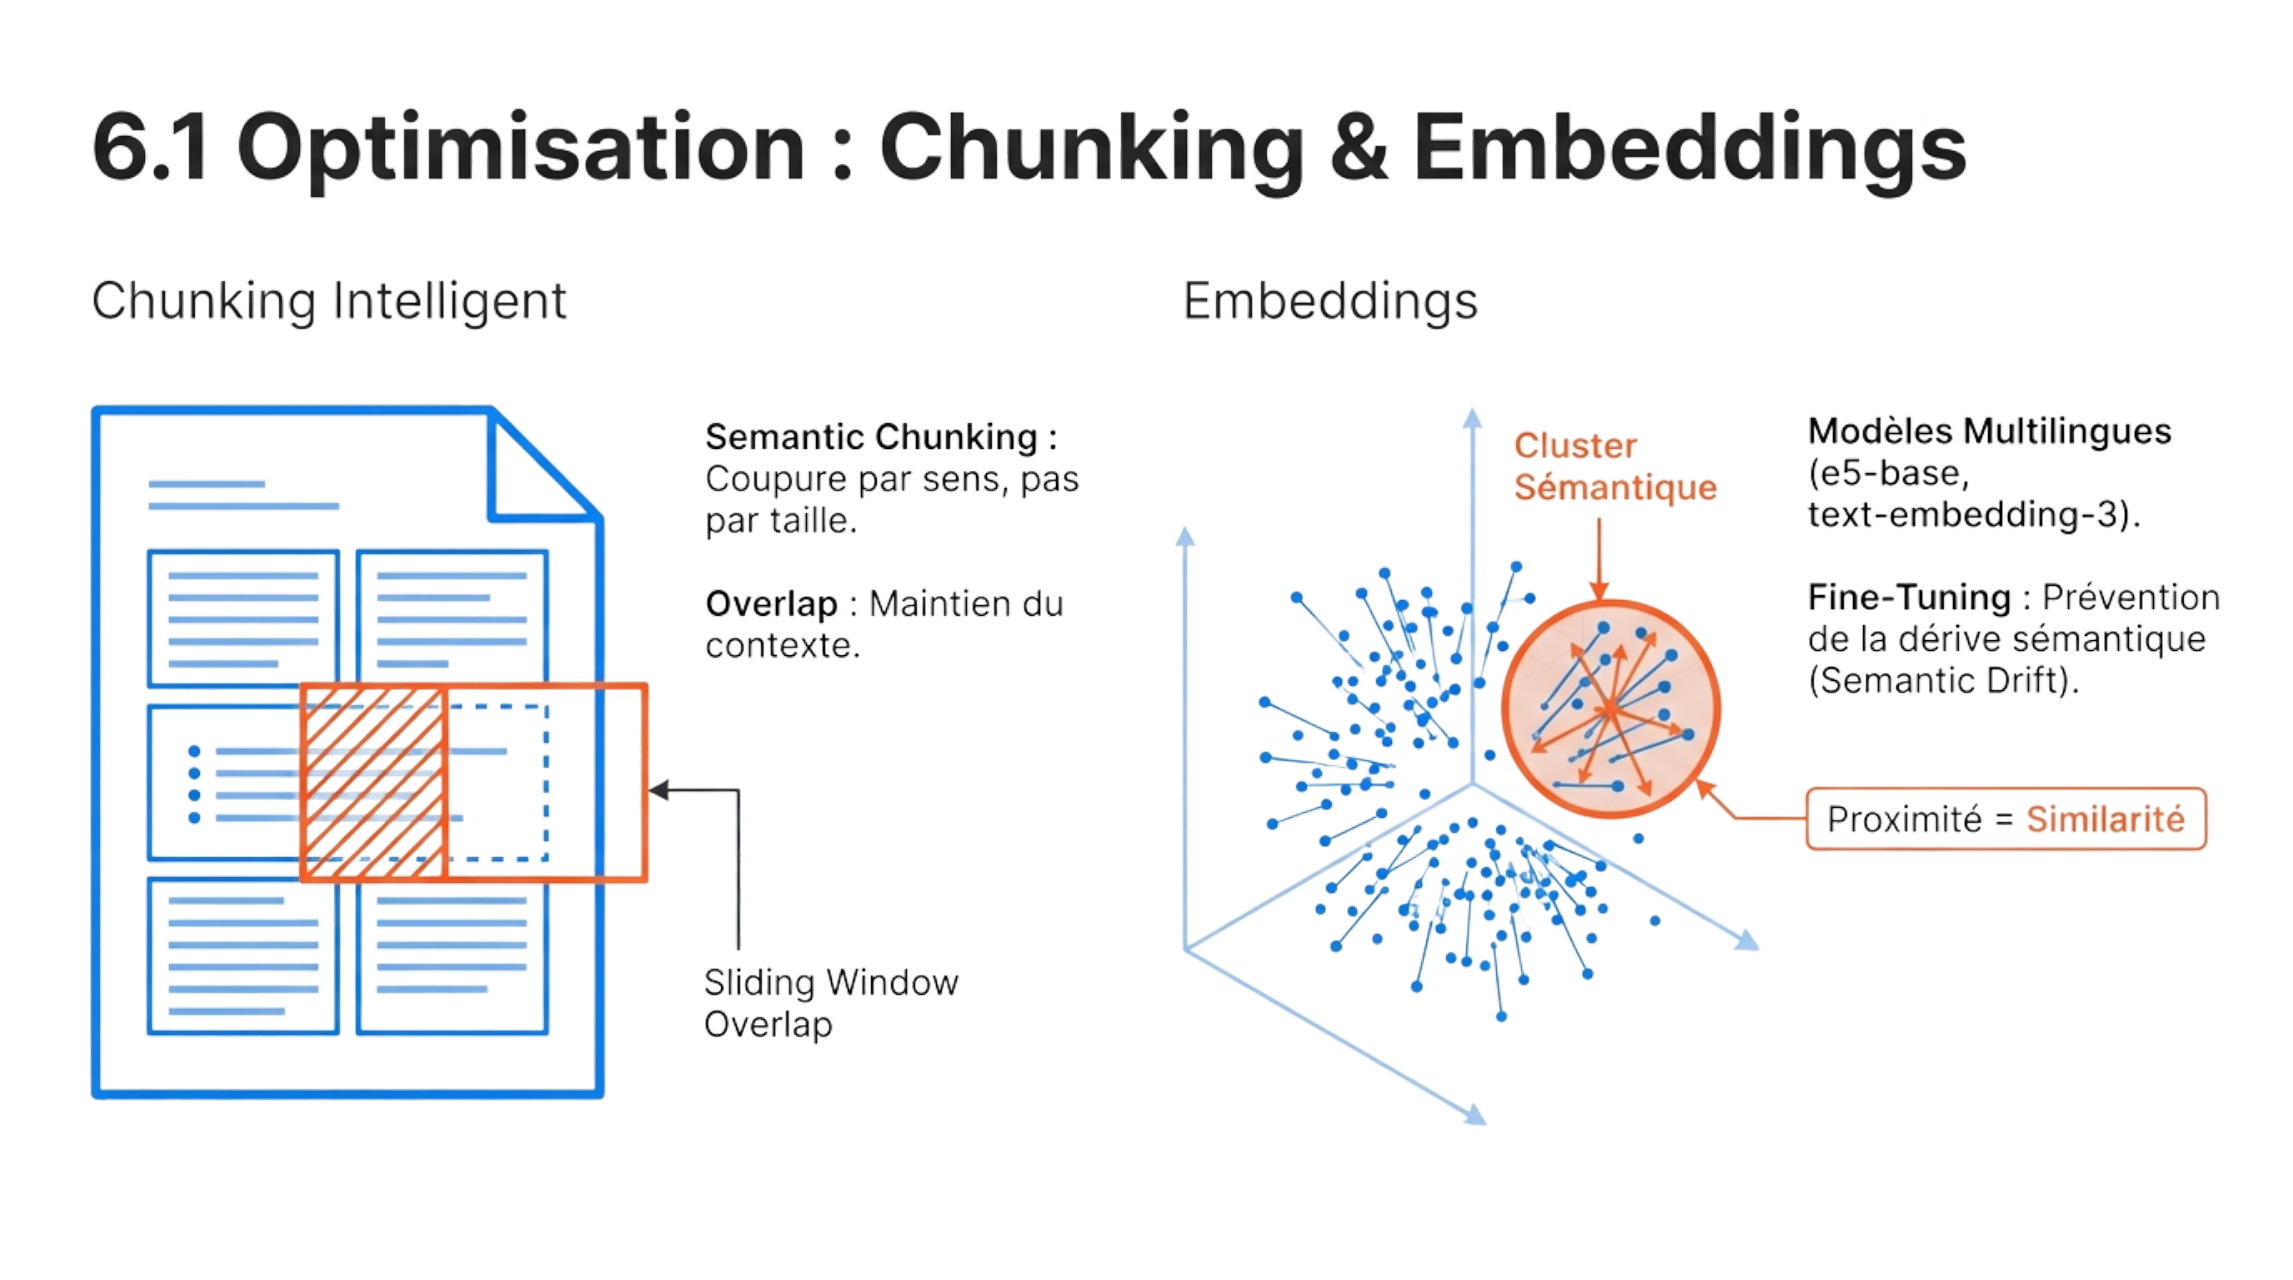
- Le chunking découpe un document en petits segments.
- Un segment trop grand contient du bruit ; un segment trop petit peut perdre le contexte.
- Le chevauchement conserve une partie du texte entre deux segments voisins.
- Les embeddings représentent le sens d'un segment sous forme de vecteur numérique.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Chunk trop petit | Précis mais incomplet | Risque de perdre le contexte |
| Chunk trop grand | Plus de contexte | Plus de bruit et de coût |
| Overlap | Continuité entre chunks | Augmente un peu le stockage |
| Embedding | Représentation sémantique | Permet la recherche vectorielle |
Schéma simplifié
Document → découpage sémantique → embeddings → index vectoriel → recherche par similarité
11Compression et recherche hybride
Idée à retenir
Obtenir une recherche plus robuste tout en réduisant la taille de la mémoire.
Explication pas à pas
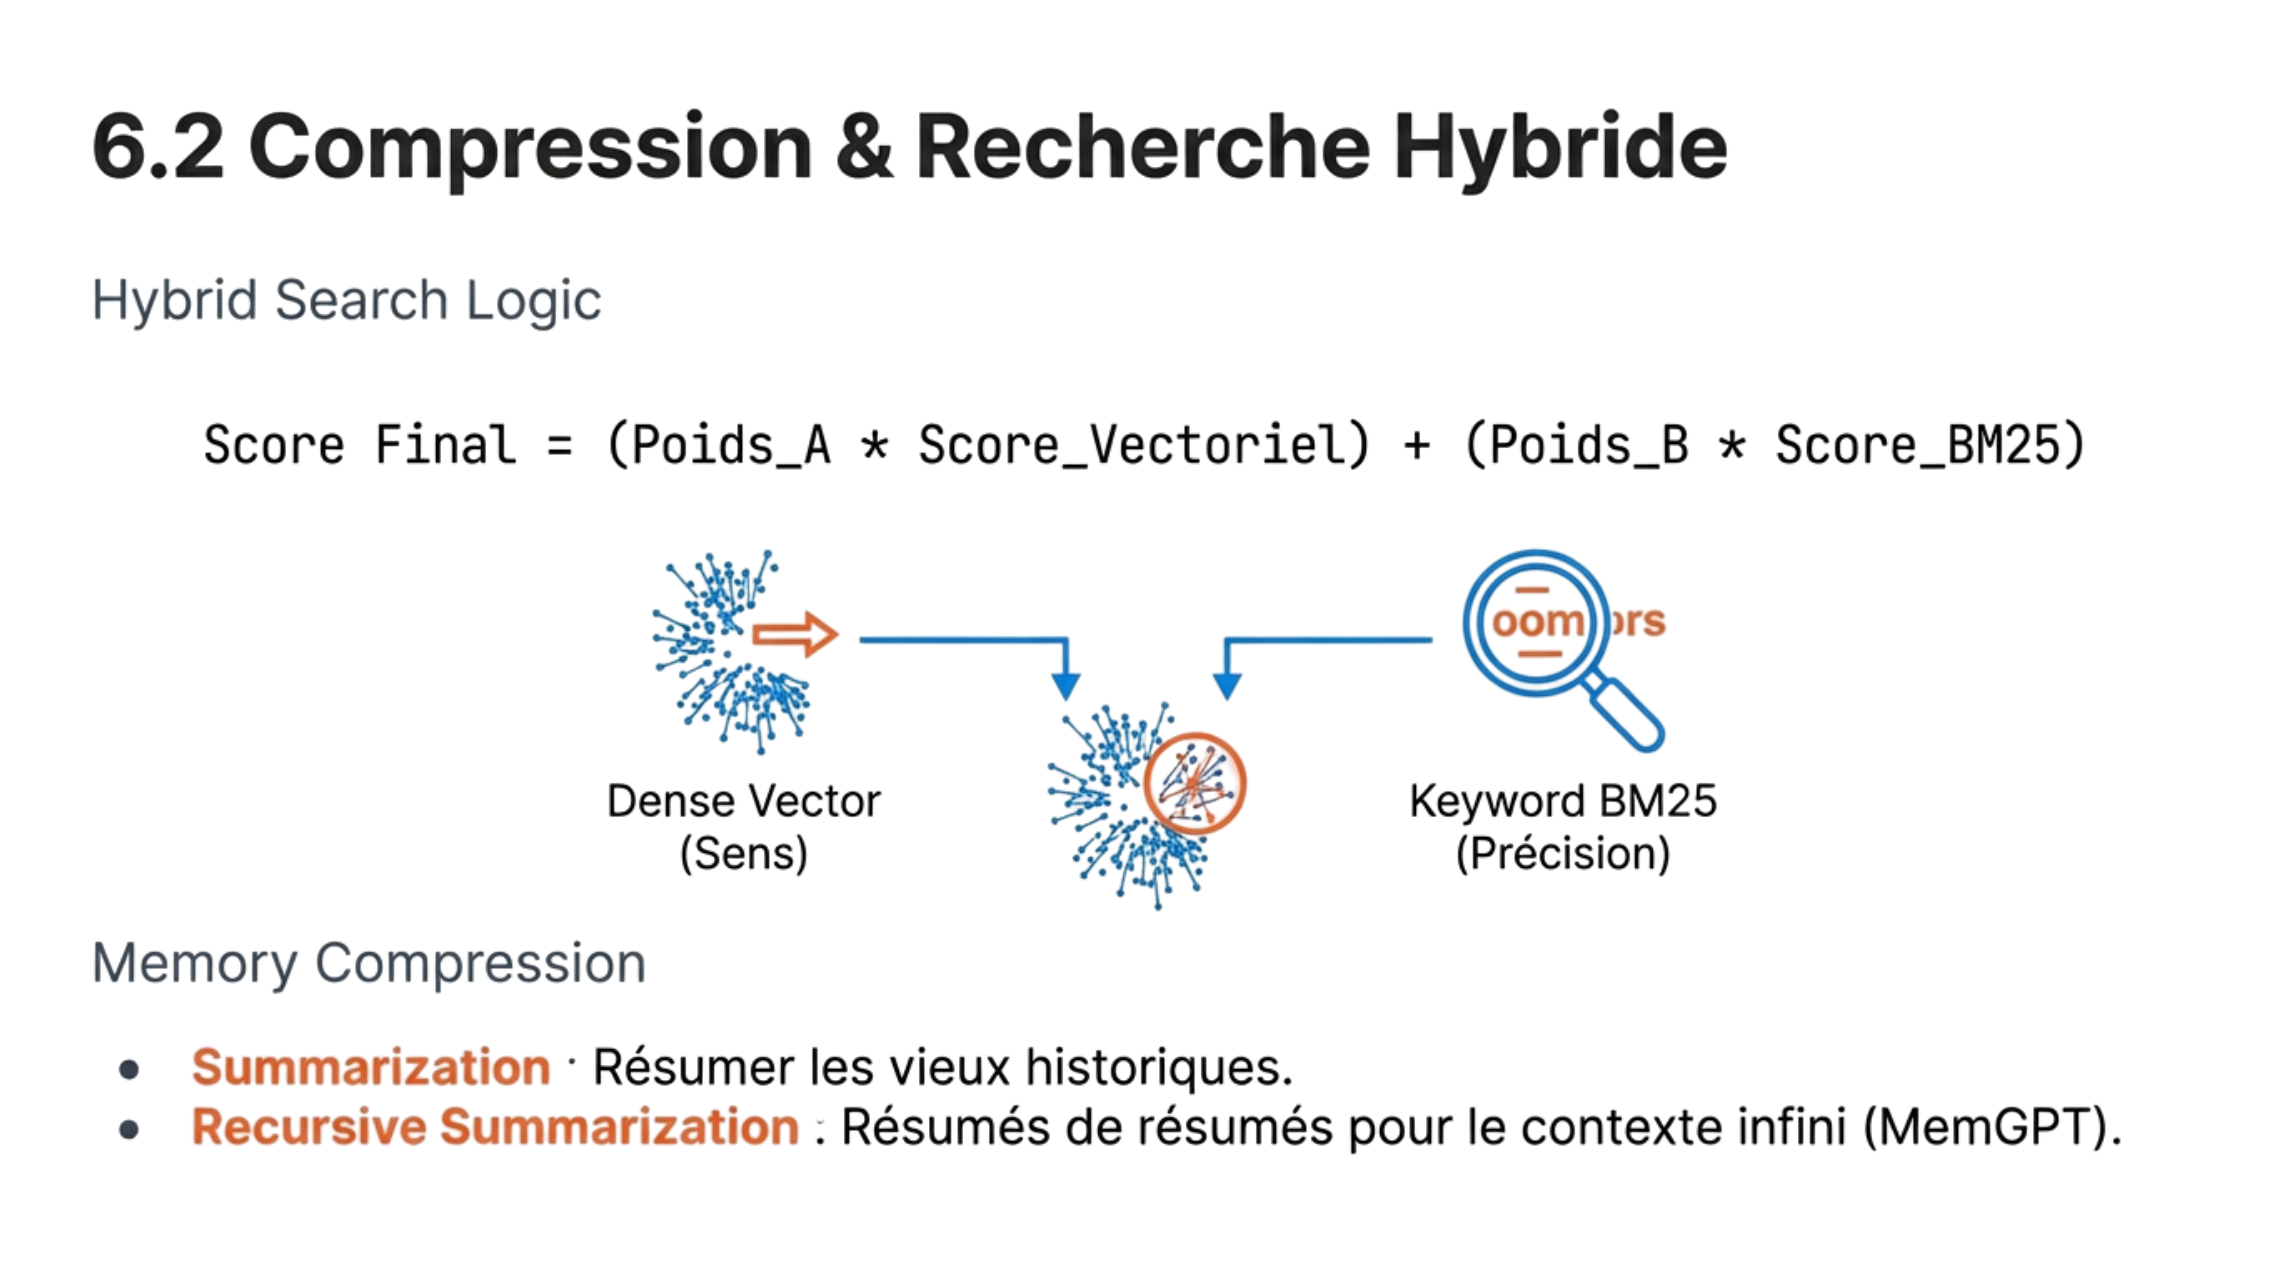
- La recherche vectorielle est forte pour le sens et les formulations proches.
- BM25 est utile pour les mots-clés, noms, références et termes exacts.
- Une recherche hybride combine les deux scores.
- La summarisation récursive peut compresser des résumés plus anciens.
| Élément | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Dense / vecteur | Similarité de sens | Questions reformulées |
| BM25 | Correspondance lexicale | Codes, noms, mots exacts |
| Hybride | Combine les deux | Meilleure robustesse |
| Résumé | Réduit la mémoire | Conserve l'essentiel |
Schéma simplifié
Requête → recherche vectorielle + BM25 → combiner les scores → reranker → retourner les meilleurs résultats
12Architecture avancée H-MEM
Idée à retenir
Organiser une grande mémoire en niveaux pour éviter de tout rechercher.
Explication pas à pas
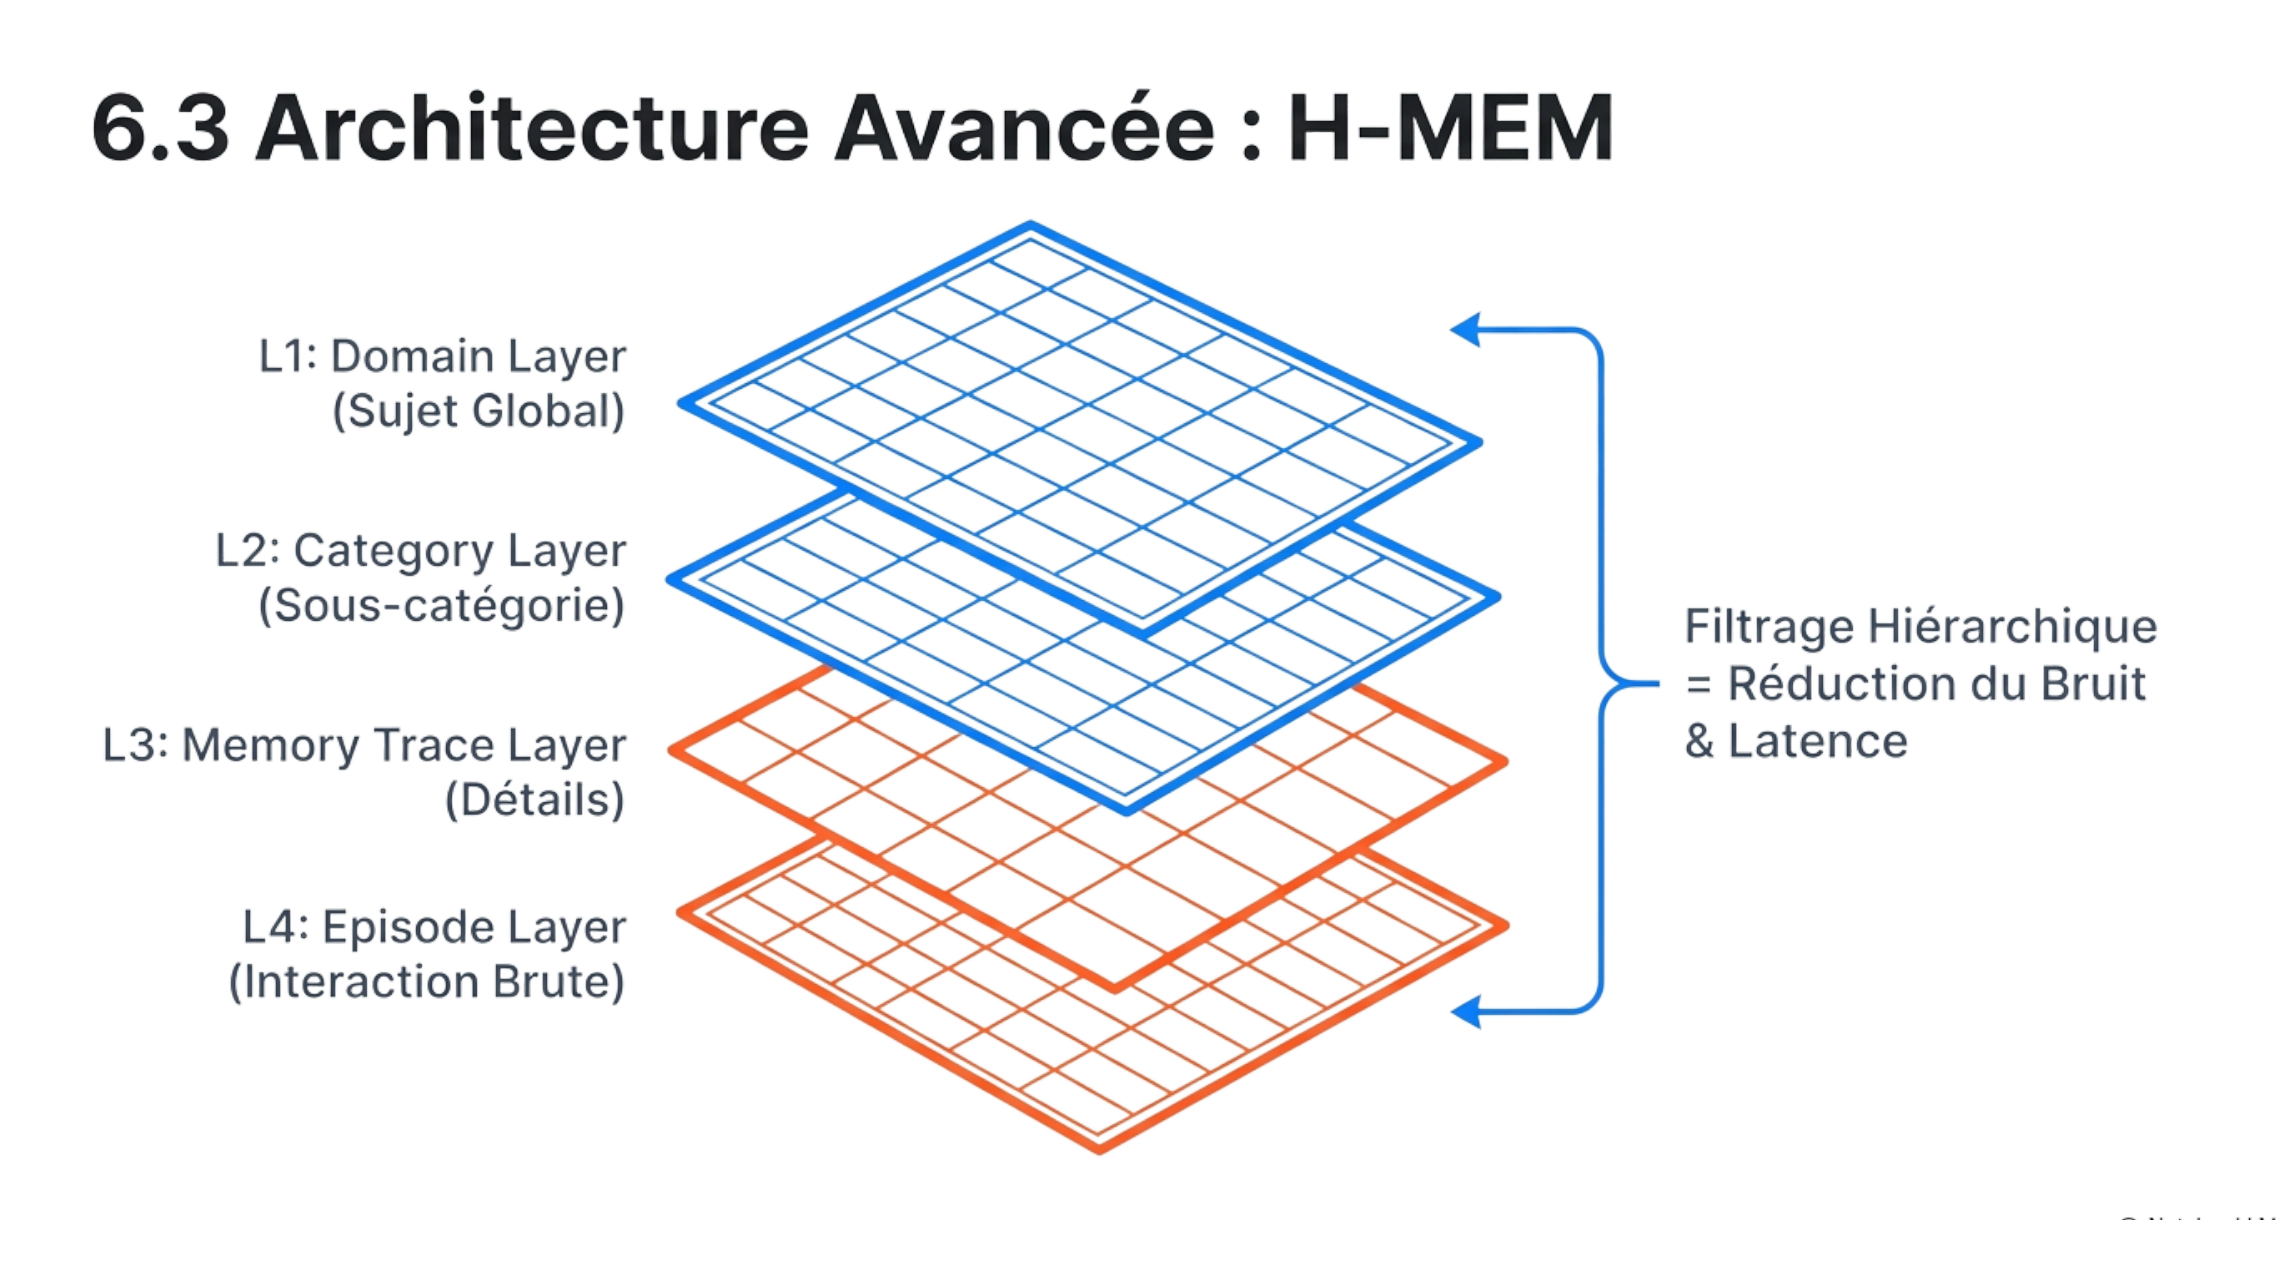
- La couche domaine représente le sujet général.
- La couche catégorie réduit la recherche à un sous-ensemble.
- La couche trace contient des détails mémoriels.
- La couche épisode conserve l'interaction brute ou l'événement source.
| Niveau | Rôle / signification | Exemple |
|---|---|---|
| L1 Domaine | Sujet global | Finance |
| L2 Catégorie | Sous-thème | Facturation |
| L3 Trace | Information détaillée | Règle précise |
| L4 Épisode | Source brute | Interaction/document |
Schéma simplifié
Requête → domaine pertinent → catégorie → traces candidates → épisode détaillé si nécessaire
13Cycle de vie, TTL et coûts
Idée à retenir
Éviter que la mémoire grandisse sans limite et coûte trop cher.
Explication pas à pas
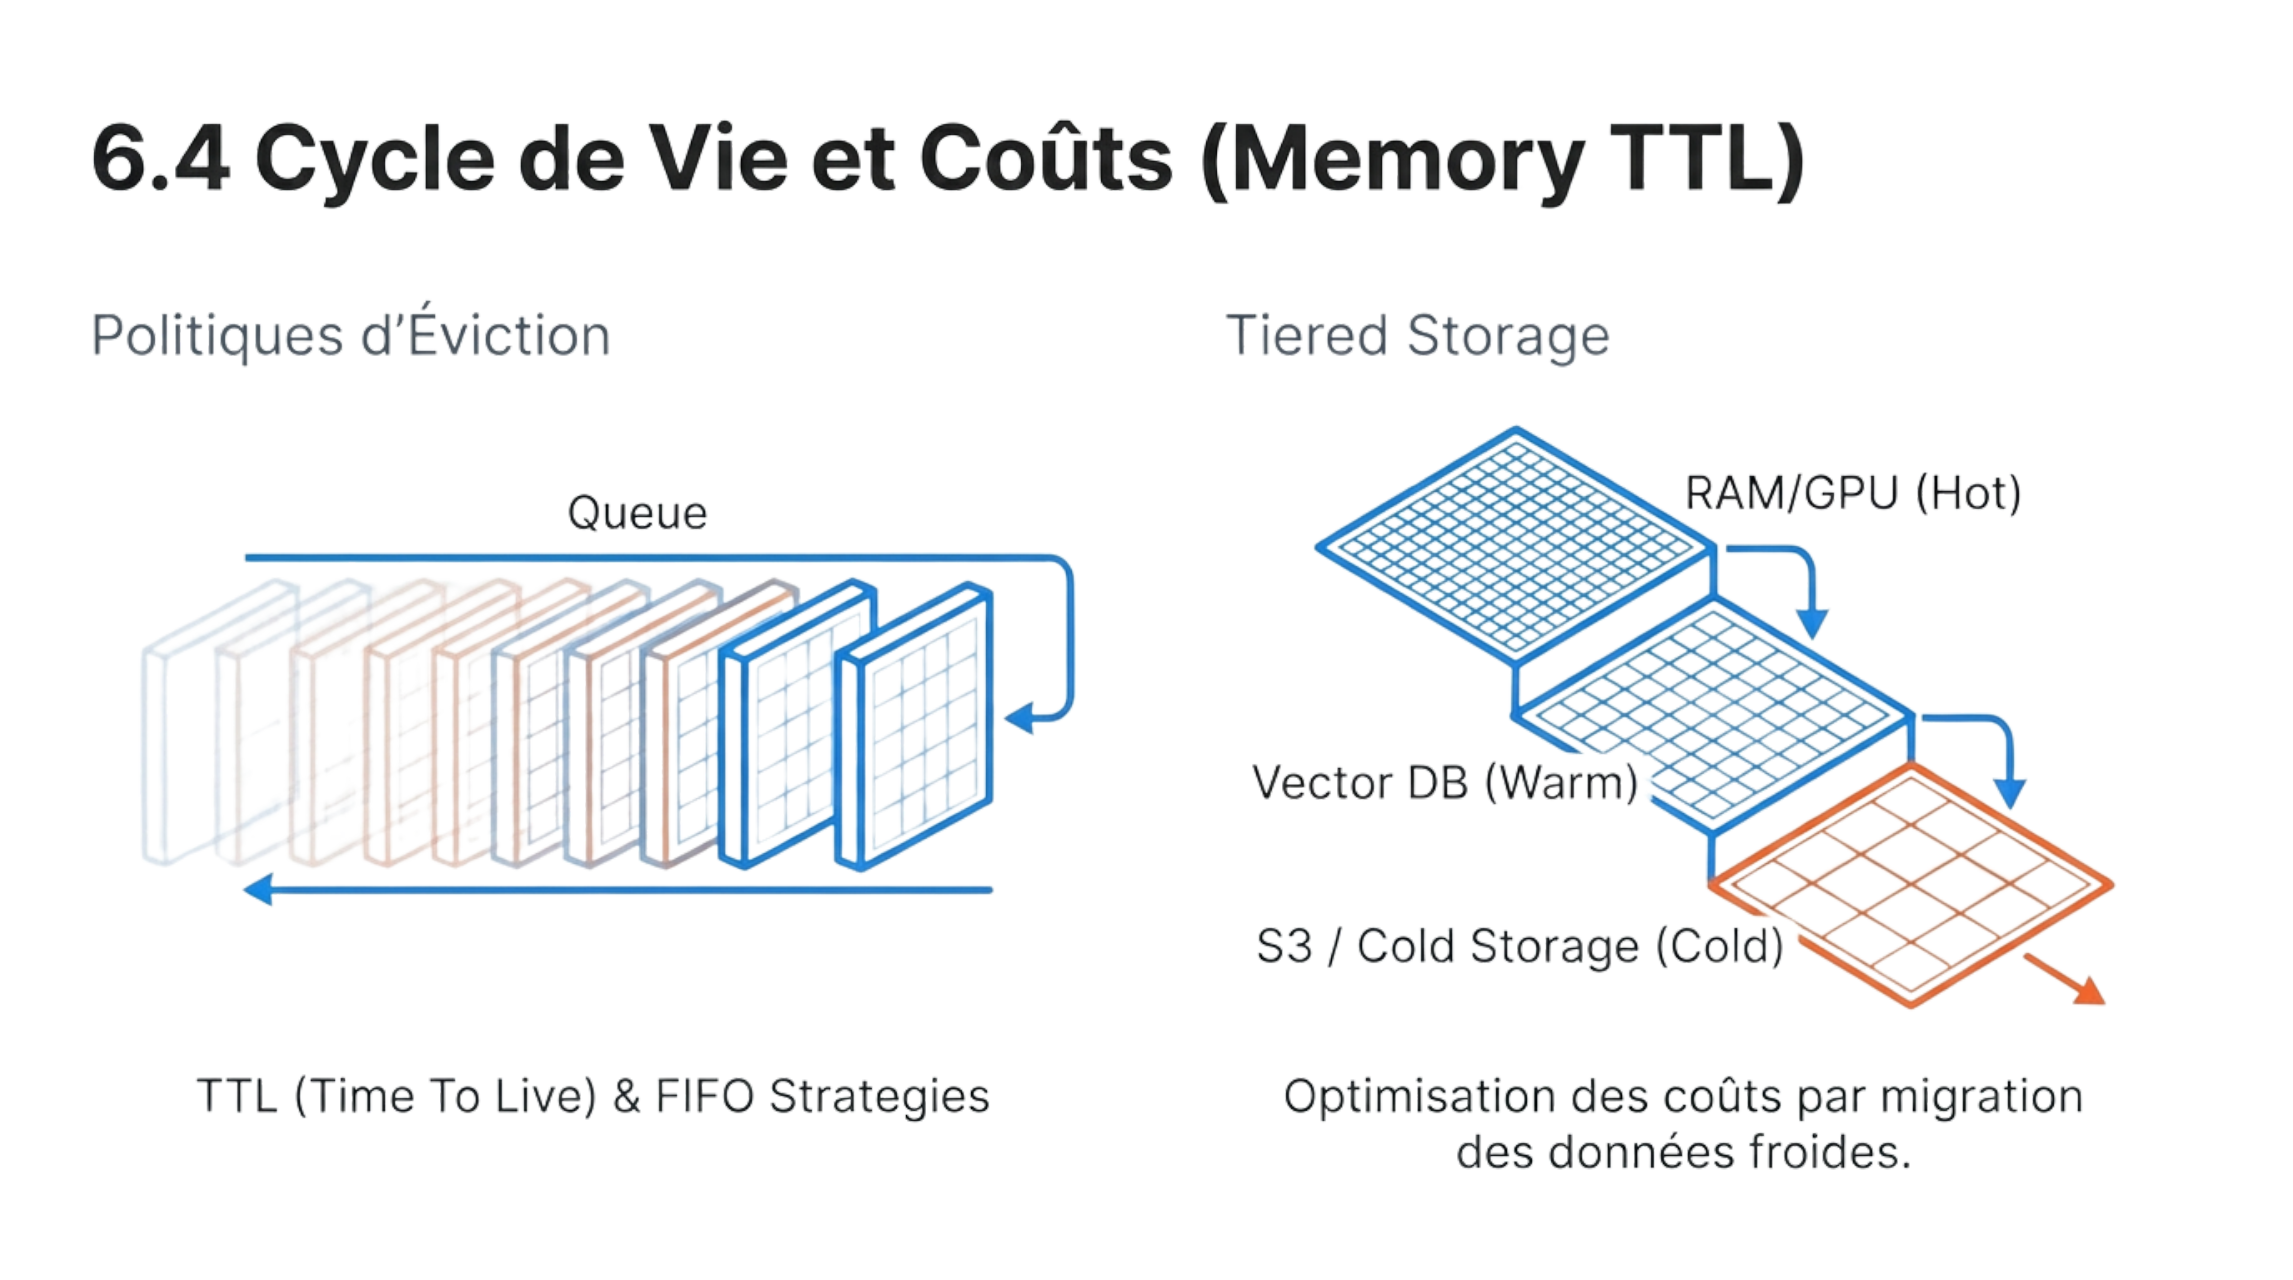
- TTL signifie Time To Live : une donnée peut expirer après une durée définie.
- FIFO retire en priorité les éléments les plus anciens.
- Le stockage par niveaux place les données fréquentes dans des supports rapides et les données froides dans des supports moins coûteux.
| Niveau | Support | Caractéristique |
|---|---|---|
| Hot | RAM / GPU | Très rapide, coûteux |
| Warm | Base vectorielle | Bon compromis |
| Cold | Archivage / S3 | Moins cher, plus lent |
| TTL / FIFO | Politique d'éviction | Contrôle la croissance |
Schéma simplifié
Nouvelle mémoire → mesurer usage/âge → Hot → Warm → Cold → suppression éventuelle
14Conclusion : vers une mémoire agentique
Idée à retenir
Retenir l'architecture générale et les bonnes questions à poser.
Explication pas à pas
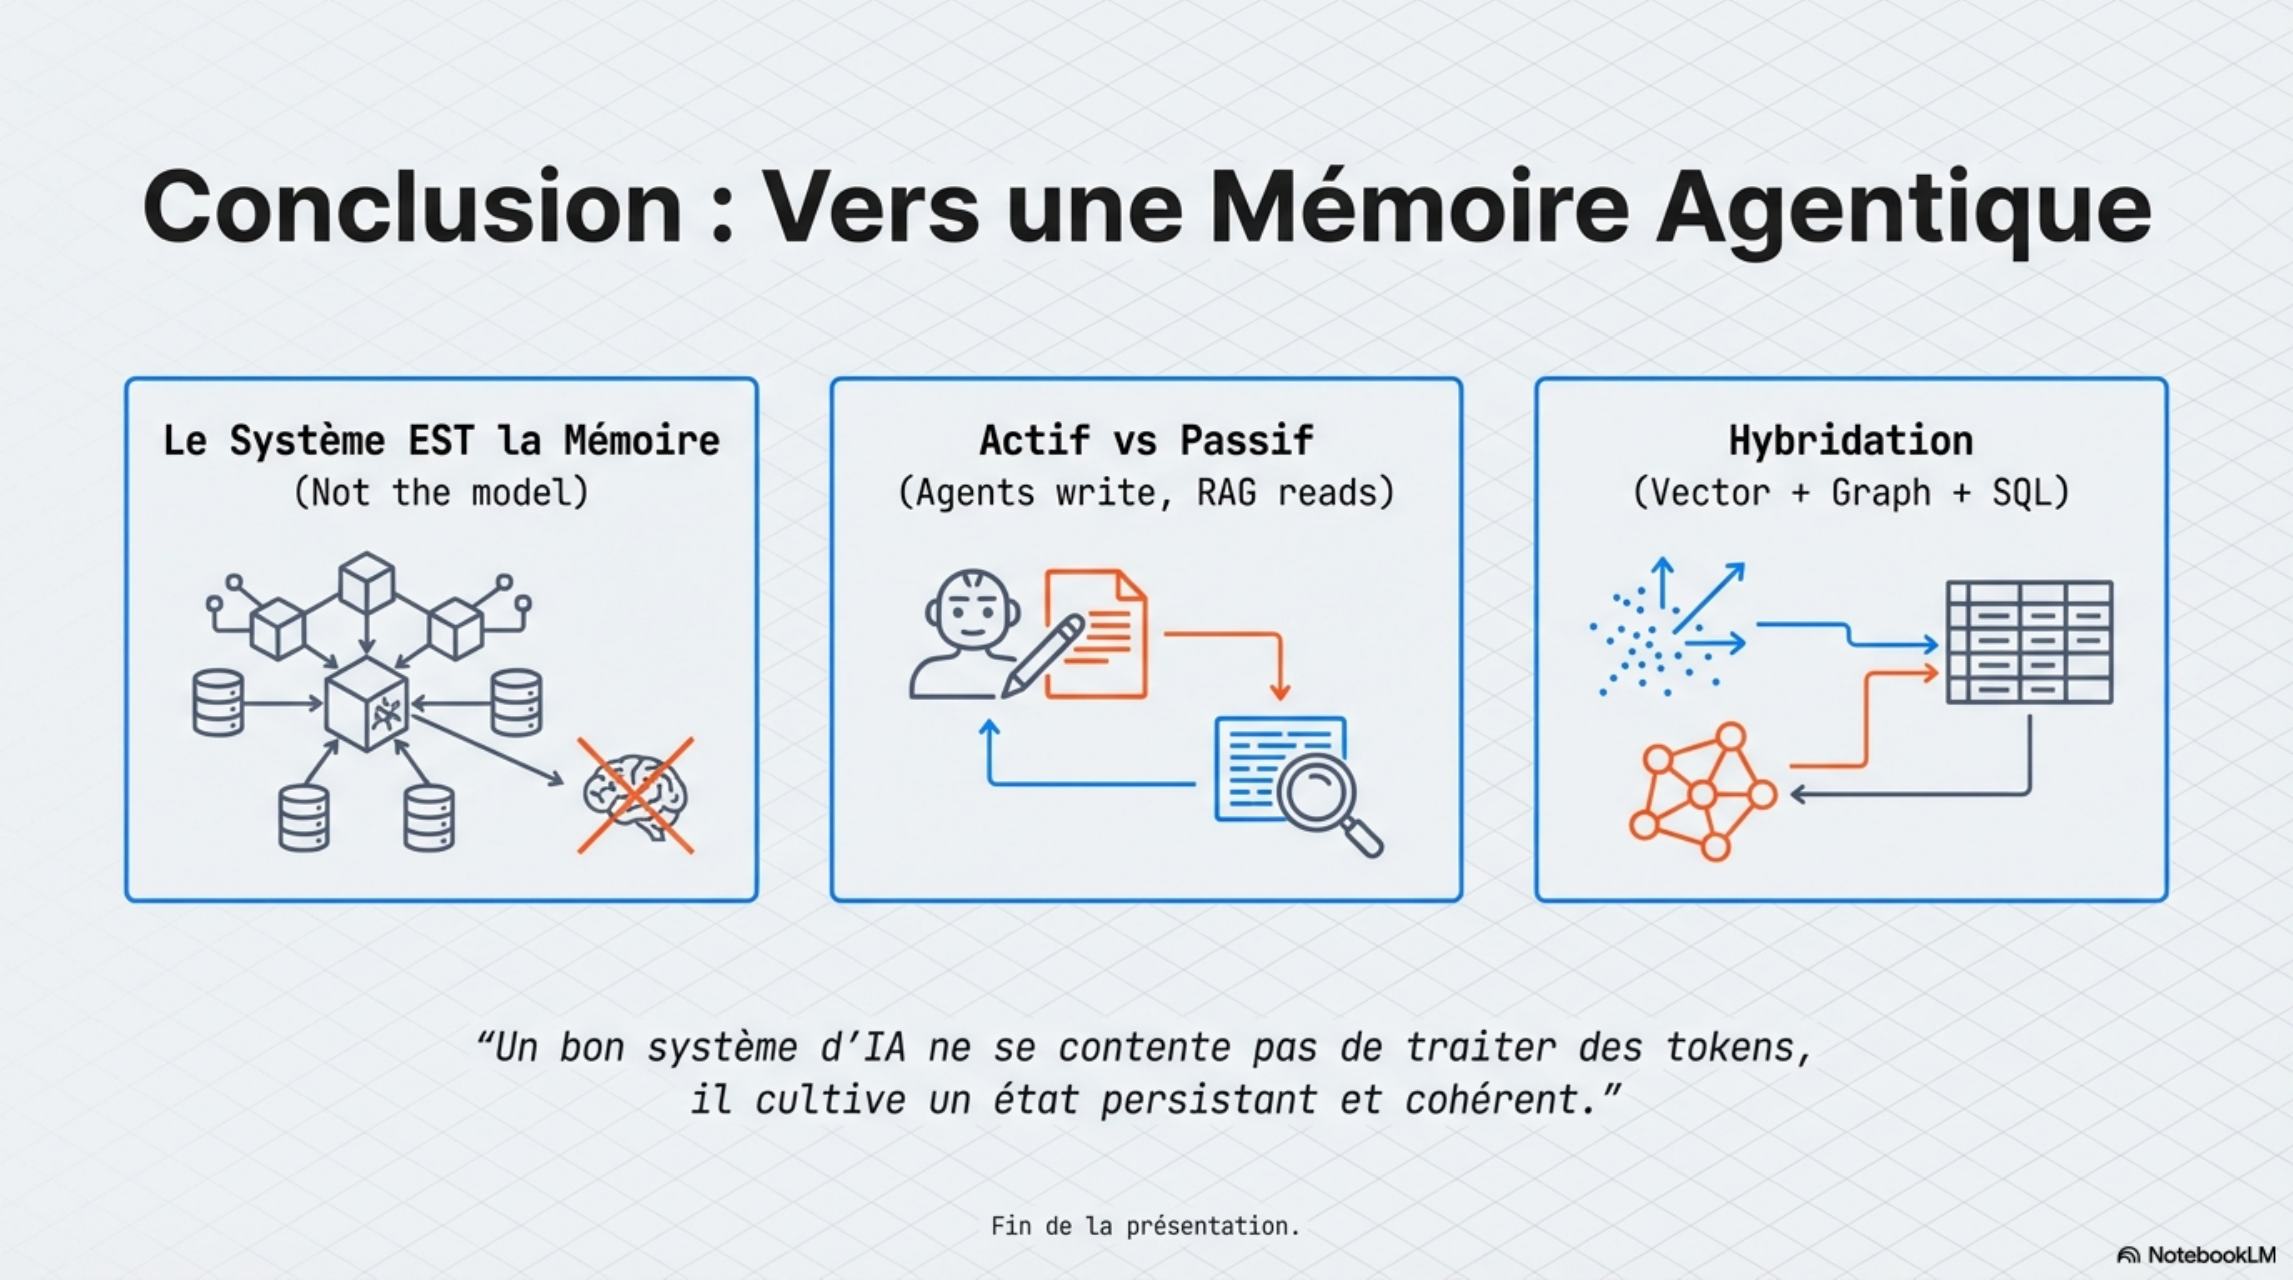
- La mémoire appartient au système complet, pas uniquement au modèle.
- Un RAG lit surtout des informations ; un agent peut aussi écrire et maintenir son état.
- Plusieurs technologies peuvent coexister : vecteurs, graphes et SQL.
- Une bonne mémoire doit être pertinente, compacte, récupérable, actualisable et économiquement soutenable.
| Qualité | Rôle / signification | Exemple ou remarque |
|---|---|---|
| Pertinence | Conserver ce qui aide réellement | Réduire le bruit |
| Persistance | Garder ce qui doit survivre | Continuité |
| Récupération | Retrouver rapidement | Bonne réponse |
| Maintenance | Mettre à jour / supprimer | Éviter les souvenirs faux |
Architecture globale en une ligne
Utilisateur → requête → mémoire court terme + recherche long terme → sélection/reranking → contexte → LLM/Agent → réponse → mise à jour éventuelle de la mémoire
Fiche de révision rapide
| Concept | Définition simple |
|---|---|
| Mémoire court terme | Ce dont le modèle a besoin maintenant. |
| Mémoire long terme | Ce qui doit être conservé et retrouvé plus tard. |
| RAG | Chercher des informations pertinentes avant de générer la réponse. |
| Chunking | Découper les documents en segments recherchables. |
| Embedding | Transformer le sens du texte en vecteurs numériques. |
| Reranking | Reclasser les résultats pour garder les plus pertinents. |
| Mémoire d'entité | Conserver un état compact sur une entité importante. |
| Recherche hybride | Combiner recherche sémantique et mots-clés. |
| TTL | Définir combien de temps une mémoire doit rester active. |
| Mémoire agentique | Mémoire qu'un agent peut lire, écrire, mettre à jour et supprimer. |
Le meilleur système n'est pas celui qui mémorise tout, mais celui qui sait quoi conserver, où le conserver et quand le récupérer.